企业灾备技术方案:别等系统崩了才想起补窟窿
上个月跟做电商的老陈喝酒,他脸肿得像发面馒头。大促当天核心机房跳闸,存在同机房的备份直接一起歇了。整整六个小时,用户刷不出商品页,直接亏了近两百万。
这事说出来离谱,但真不是个例。我见过太多公司,把“做灾备”当成走流程,要么直接省了预算,要么被厂商忽悠买了完全不匹配的方案,真出事了才追悔莫及。
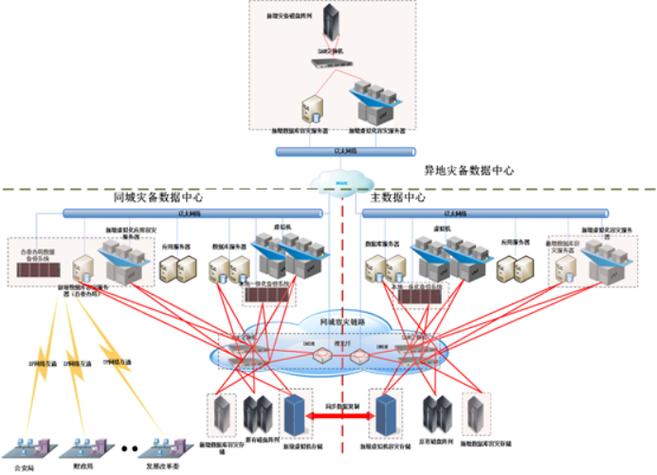 传统企业两地三中心灾备机房布局图
说实话,传统灾备方案本来就是给超大型企业设计的,重资产,高成本,百分之九十的中小公司根本扛不住,也没必要扛。被架着花钱买了高大上的方案,最后变成放在那吃灰的摆设,太常见了。
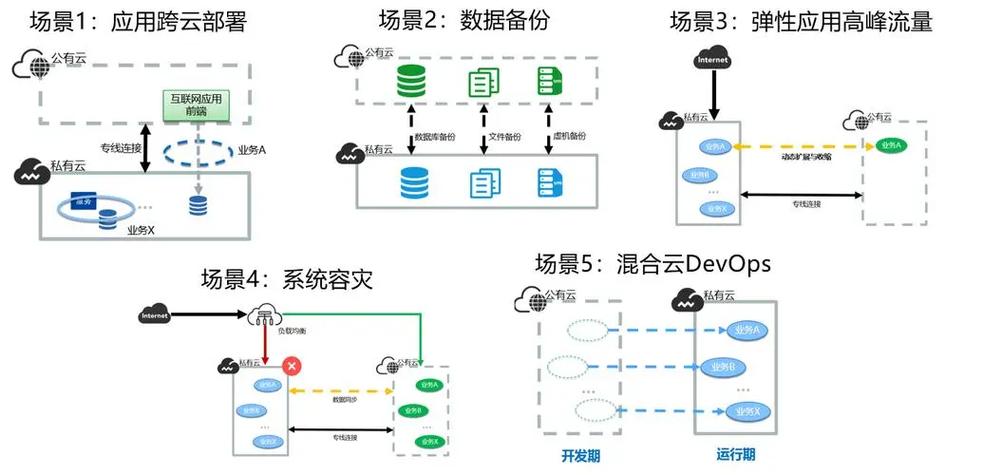 云原生混合云灾备技术架构图
不过话说回来,最近还有个新东西我觉得特别好,就是AI辅助自动灾备演练。不用人工跑流程,系统自动定期检测数据同步状态,模拟故障场景测恢复速度,有问题直接告警。之前我认识一个运维,为了做灾备演练,连续一个月加班,最后直接提了辞职,有了这玩意儿,真的能省好多事。
 选灾备技术方案的核心标准,记下来不吃亏
不管选什么方案,绕不开几个核心判断点,我整理出来了,你对着看就行。
第一个,RTO和RPO一定要匹配你的业务,别盲目追求参数。很多厂商拿“零RTO秒级切换”当卖点,你一个做企业官网的,就算停两个小时也不会亏多少钱,犯不着花几百万买这个参数。RTO就是你能接受业务停多久,RPO就是你能接受丢多少数据,先把这两个数算清楚,再去找方案,别被厂商牵着走。
第二个,一定要算全周期成本,别只看初期报价。很多厂商报价的时候只报硬件或者云资源的钱,把后面的带宽费、维护费、演练服务费藏起来,等你用上了,年年涨价,最后总成本比初期报价翻两三倍都不奇怪。签合同之前,把所有隐性成本都问清楚,别嫌麻烦。
第三个,一定要选演练方便的方案。如果你的灾备方案演练一次要停业务大半天,全公司配合折腾,那管理层肯定不会同意你经常练,时间长了肯定出问题。好的灾备方案,可以做不影响现有业务的模拟演练,随时测,不用兴师动众,才能保证真出事的时候能用。
前阵子有个做职业教育的客户找我,他们三年前花几十万搭了传统灾备,演练一次要停课半天,校长怕影响学生口碑,一直不让练。去年本地机房出故障,要恢复的时候才发现,数据同步已经断了三个多月,直接丢了几千个新生的报名数据,口碑掉了一大截,新生招不进来,差点把校区关了。
灾备这东西,平时用不上,关键时候能救命。不用你盲目追最贵的,但一定要选最适合你的。毕竟,没人想真出事的时候,才拍着大腿说当初怎么没多上点心。
别再被厂商忽悠:传统灾备技术方案的坑你踩了几个
不少人对灾备的认知还停留在“存个备份”的阶段。还有更多厂商,上来就给你推百万级的两地三中心方案,张嘴就是行业标杆配置,可从来不会问你,你的企业一年营收多少,核心业务能接受停多久。 第一个大坑,就是把备份当灾备。备份是把数据存起来,灾备是出问题的时候能快速把业务切走,这完全是两码事。你把备份跟主业务放同一个机房,机房炸了,备份不也跟着没了? 第二个大坑,贪大求全,把所有数据都放进灾备体系。我之前接触过一家地方国企,他们把十年前的旧办公文件都放进了实时灾备,存储成本直接翻了四倍,其实核心业务也就不到20%的数据需要实时同步,剩下的完全可以存在低成本冷备里,谁没事去翻十年前的旧文件啊。 第三个大坑,建完就不管,常年不做演练。很多公司花了大价钱搭完灾备,就把这事忘在脑后,一年都不练一次恢复。真出事了才发现,数据同步断了大半年,备份文件早就损坏了,根本恢复不出来。传统企业两地三中心灾备机房布局图
说实话,传统灾备方案本来就是给超大型企业设计的,重资产,高成本,百分之九十的中小公司根本扛不住,也没必要扛。被架着花钱买了高大上的方案,最后变成放在那吃灰的摆设,太常见了。
当下主流灾备技术方案,怎么选才适合你
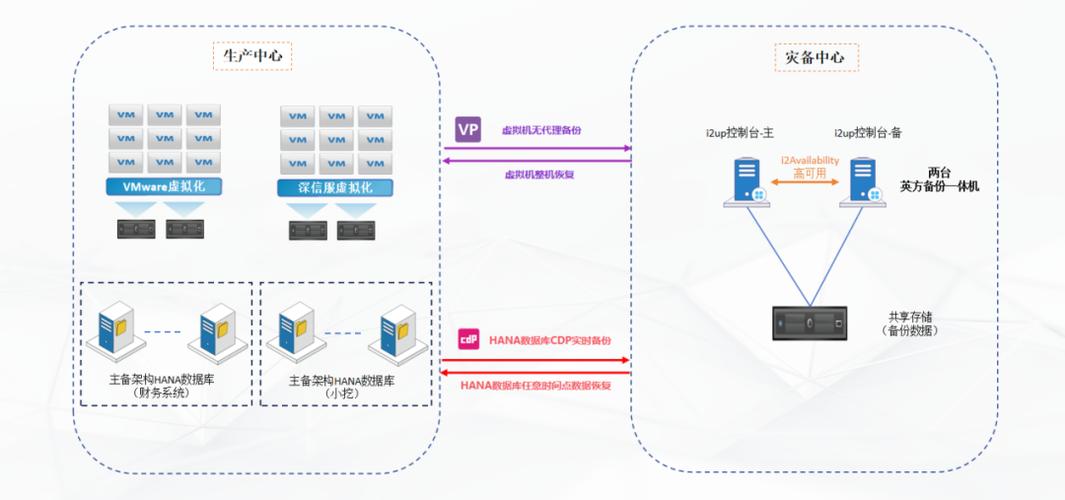
这两年云技术普及之后,灾备的玩法早就变了。再也不是只有砸钱建机房这一条路可选了。 现在针对不同规模的企业,已经有非常成熟的分层方案了。对于中小微企业来说,云原生跨区域多活灾备方案性价比真的拉满。成本只有传统自建两地三中心的三分之一不到,甚至很多中小团队一年几万块就能搞定。出事之后,跨区域切换最快几分钟就能完成,大部分业务根本感知不到中断。 对于有数据合规要求的中大型企业,现在主流选的是混合云灾备方案。核心敏感数据放在本地自建的灾备节点,满足合规要求,非核心的日志、历史数据放在公有云冷备里,成本直接降了一大半,安全和省钱两头都占到了。云原生混合云灾备技术架构图
不过话说回来,最近还有个新东西我觉得特别好,就是AI辅助自动灾备演练。不用人工跑流程,系统自动定期检测数据同步状态,模拟故障场景测恢复速度,有问题直接告警。之前我认识一个运维,为了做灾备演练,连续一个月加班,最后直接提了辞职,有了这玩意儿,真的能省好多事。
选灾备技术方案的核心标准,记下来不吃亏
选灾备技术方案的核心标准,记下来不吃亏
不管选什么方案,绕不开几个核心判断点,我整理出来了,你对着看就行。
第一个,RTO和RPO一定要匹配你的业务,别盲目追求参数。很多厂商拿“零RTO秒级切换”当卖点,你一个做企业官网的,就算停两个小时也不会亏多少钱,犯不着花几百万买这个参数。RTO就是你能接受业务停多久,RPO就是你能接受丢多少数据,先把这两个数算清楚,再去找方案,别被厂商牵着走。
第二个,一定要算全周期成本,别只看初期报价。很多厂商报价的时候只报硬件或者云资源的钱,把后面的带宽费、维护费、演练服务费藏起来,等你用上了,年年涨价,最后总成本比初期报价翻两三倍都不奇怪。签合同之前,把所有隐性成本都问清楚,别嫌麻烦。
第三个,一定要选演练方便的方案。如果你的灾备方案演练一次要停业务大半天,全公司配合折腾,那管理层肯定不会同意你经常练,时间长了肯定出问题。好的灾备方案,可以做不影响现有业务的模拟演练,随时测,不用兴师动众,才能保证真出事的时候能用。
前阵子有个做职业教育的客户找我,他们三年前花几十万搭了传统灾备,演练一次要停课半天,校长怕影响学生口碑,一直不让练。去年本地机房出故障,要恢复的时候才发现,数据同步已经断了三个多月,直接丢了几千个新生的报名数据,口碑掉了一大截,新生招不进来,差点把校区关了。
灾备这东西,平时用不上,关键时候能救命。不用你盲目追最贵的,但一定要选最适合你的。毕竟,没人想真出事的时候,才拍着大腿说当初怎么没多上点心。