容错计算技术:藏在科技落地背后的隐形护城河
你刷这篇文章的时候,你的手机、传输文章的服务器,至少已经发生过三五次微小的硬件错误了。但是你啥都没感觉到。错被悄悄修好了。这就是容错计算技术在干活。
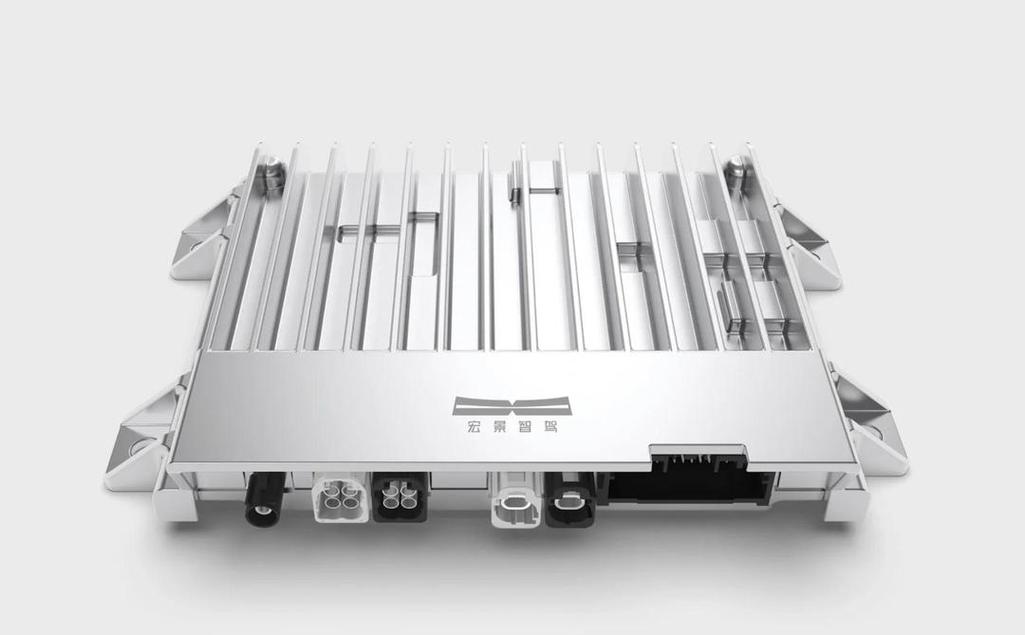 自动驾驶域控制器容错计算模块实物图
你看,原来错了可以重来的场景,现在根本给不起重来的成本。云计算厂商拼可靠性,差一个九个就是天差地别,用户说走就走。大模型厂商拼训练成功率,错一次就是几百万打水漂。自动驾驶拼安全性,一次事故就是万劫不复。容错计算技术就这样从后台走到了前台,变成了所有人都抢着补的短板。
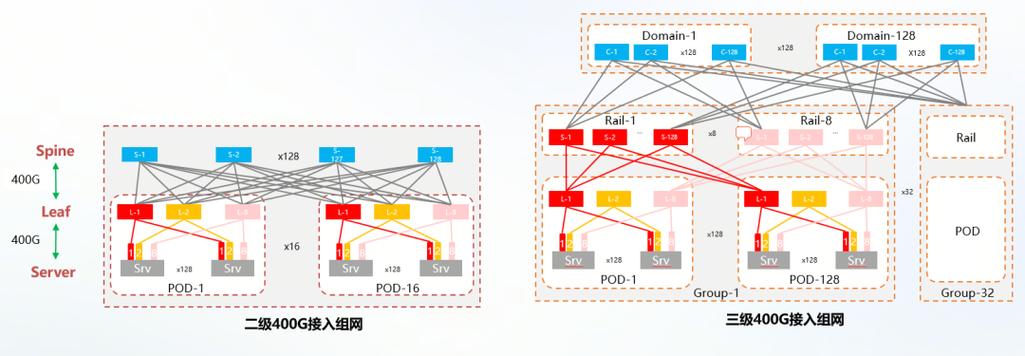 大模型训练集群容错计算调度示意图
说实话我之前听过一个段子,某创业公司做千亿参数大模型训练,跑了半个月出了个小错,就是因为舍不得成本做在线容错,直接回滚到一周前,损失几十万的电费算力费,项目组蹲在机房门口吃了一周泡面,你说惨不惨?
不过话说回来,很多人对容错有个误区:觉得不就是多买几份硬件堆着吗?错得离谱。堆硬件那是最笨的方法,成本高到离谱,现在谁也扛不住几千块高端显卡全堆双份啊。所以现在玩的都是动态冗余,哪里容易出问题就给哪里多留余量,冷门地方少留,甚至不留,既保证安全又省成本,这才是真本事。
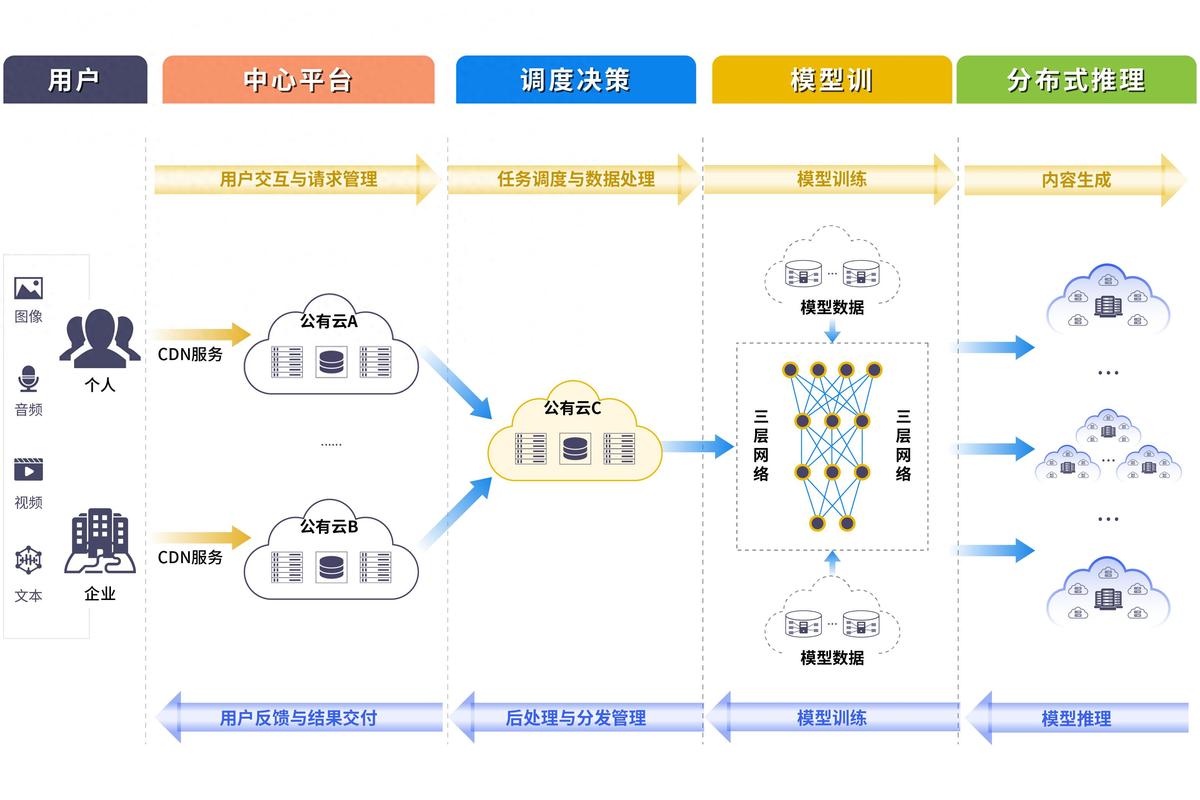 容错计算技术的下一个爆发点在哪
现在业内最热的方向,其实就两个,一个是AI原生的容错,另一个是容错量子计算。
先说AI原生容错,原来的容错规则都是人写的,哪容易出错全靠工程师的经验判断,现在直接让AI自己学,根据不同任务的运行数据动态调整冗余分配,学出来的动态调度比人写的省30%以上的冗余,算力省下来就是真金白银,一块几千块的显卡,省出来的算力就能多跑一个任务,一年下来能省几百万。
容错量子计算更不用说了,现在的量子比特,本身出错率就高到离谱,跑稍微复杂点的计算,错误堆得结果都没法看,量子计算要真的落地商用,必须先过容错这一关,现在全世界的顶尖团队都在卷这个,谁先做出来实用化的容错量子芯片,谁就是下一个行业霸主,这个一点都不夸张。
我接触过几个做容错计算创业的团队,都很低调,闷头挣钱,客户全是头部云计算公司、自动驾驶厂商,根本不愁订单。现在所有人都在抢显卡,都在卷大模型参数,没人注意到,容错才是那个能把落地门槛拉起来的东西。你参数再大,训练一次错一次,跑起来动不动就出故障,谁敢用你做核心业务?对吧?
很多技术都是这样,站在聚光灯下的永远是新出来的花活,ChatGPT出来之后全聊大模型,没人聊背后支撑它稳跑几十万调用的容错计算。但真正能让技术从实验室的PPT走到你我身边的,恰恰就是这些不起眼的「后台清洁工」。它不抢C位,但是缺了它,再炫的科技秀场都得垮台。
为什么容错计算技术现在突然成了香饽饽
这技术其实一点都不新,早在上世纪航天工程里就用了,NASA往火星发探测器,总不能坏了飞回来修吧?所以从那时候起,冗余容错就是航天项目的标配。 过去几十年,民用领域根本没人把它当回事。不就是个出错备份吗?大不了重启,大不了换硬件,花那钱做冗余干嘛? 这两年风向全变了。OpenAI训练GPT-4的时候,一次训练成本据说近亿美元,几千块显卡连转几个月,只要中间一块显卡出一个比特的错误,整个训练出来的模型就废了。 亏到哭都没眼泪。 自动驾驶更不用说,高速行驶的时候,一个摄像头出错,毫米波雷达数据乱掉,没有容错,直接就是车毁人亡的事故。自动驾驶域控制器容错计算模块实物图
你看,原来错了可以重来的场景,现在根本给不起重来的成本。云计算厂商拼可靠性,差一个九个就是天差地别,用户说走就走。大模型厂商拼训练成功率,错一次就是几百万打水漂。自动驾驶拼安全性,一次事故就是万劫不复。容错计算技术就这样从后台走到了前台,变成了所有人都抢着补的短板。
别被名字唬住,容错计算的核心其实很简单
很多人一听这名字就觉得高深,一堆专业术语绕得人头大,其实说白了,就是两句话:提前留好后手,错了立刻换手上。 业内一般分成两类,硬件容错和软件容错。硬件容错就是多放一份核心零件,比如银行的核心服务器,都是双电源双主板,一个坏了另一个几毫秒内就能顶上去,用户连卡顿都感觉不到。软件容错就更巧了,不是简单备份数据,是通过算法把错误给找出来修掉,比如你传文件的时候的校验码,其实就是最简单的软件容错。 现在的高端玩法比这个复杂多了。比如大模型训练的时候,会把不同层的模型分布式存在上百上千块不同显卡上,容错计算会动态把出错显卡上的任务迁移到空闲的冗余卡上,整个过程不中断训练,啥都不影响,项目组该喝咖啡喝咖啡,根本不用蹲机房。大模型训练集群容错计算调度示意图
说实话我之前听过一个段子,某创业公司做千亿参数大模型训练,跑了半个月出了个小错,就是因为舍不得成本做在线容错,直接回滚到一周前,损失几十万的电费算力费,项目组蹲在机房门口吃了一周泡面,你说惨不惨?
不过话说回来,很多人对容错有个误区:觉得不就是多买几份硬件堆着吗?错得离谱。堆硬件那是最笨的方法,成本高到离谱,现在谁也扛不住几千块高端显卡全堆双份啊。所以现在玩的都是动态冗余,哪里容易出问题就给哪里多留余量,冷门地方少留,甚至不留,既保证安全又省成本,这才是真本事。
容错计算技术的下一个爆发点在哪
容错计算技术的下一个爆发点在哪
现在业内最热的方向,其实就两个,一个是AI原生的容错,另一个是容错量子计算。
先说AI原生容错,原来的容错规则都是人写的,哪容易出错全靠工程师的经验判断,现在直接让AI自己学,根据不同任务的运行数据动态调整冗余分配,学出来的动态调度比人写的省30%以上的冗余,算力省下来就是真金白银,一块几千块的显卡,省出来的算力就能多跑一个任务,一年下来能省几百万。
容错量子计算更不用说了,现在的量子比特,本身出错率就高到离谱,跑稍微复杂点的计算,错误堆得结果都没法看,量子计算要真的落地商用,必须先过容错这一关,现在全世界的顶尖团队都在卷这个,谁先做出来实用化的容错量子芯片,谁就是下一个行业霸主,这个一点都不夸张。
我接触过几个做容错计算创业的团队,都很低调,闷头挣钱,客户全是头部云计算公司、自动驾驶厂商,根本不愁订单。现在所有人都在抢显卡,都在卷大模型参数,没人注意到,容错才是那个能把落地门槛拉起来的东西。你参数再大,训练一次错一次,跑起来动不动就出故障,谁敢用你做核心业务?对吧?
很多技术都是这样,站在聚光灯下的永远是新出来的花活,ChatGPT出来之后全聊大模型,没人聊背后支撑它稳跑几十万调用的容错计算。但真正能让技术从实验室的PPT走到你我身边的,恰恰就是这些不起眼的「后台清洁工」。它不抢C位,但是缺了它,再炫的科技秀场都得垮台。