大数据技术研发:藏在聚光灯背后的坑与新机会
上个月跟一位蹲在大数据研发一线快十年的老大哥喝酒,他酒过三巡吐出一句话:现在整个行业的目光都粘在大模型上,没人记得,大模型的半条命,捏在大数据研发手里。
这话我信。
前几年圈里什么阿猫阿狗都敢说自己做大数据,拉个集群存点数据就敢对外吹自己是大数据服务商,现在潮水退了,才发现真的能把大数据研发做透的团队,没几个。
现在的大数据技术研发,早就不是拼堆机器了
早些年提起大数据,第一反应就是买服务器、搭集群,拼的是谁家硬件多,谁能存下更多数据。说实话,那时候门槛真不高,拉几个会搭Hadoop的工程师就能开门做生意。
现在完全不一样了。
大模型火了之后,整个需求逻辑全变了。原来只要离线跑数准,一天出一次报表就行,现在呢?大模型要实时推送给用户个性化结果,实时特征计算差个一秒钟,用户体验就差一大截,转化率直接掉点。
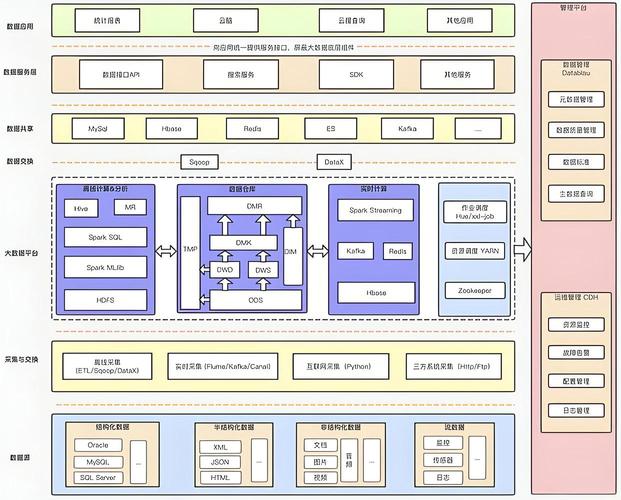 大数据实时特征计算平台架构图
我见过一个创业团队,去年拿了千万融资,一口气砸了五百万买GPU,挖了三个顶校博士做推荐大模型,结果上线前测试,出结果平均要三秒,用户根本等不了。查了半个月才发现问题出在哪?大数据层的特征抽取太慢,GPU在那边空等数据,跑不满算力,纯纯浪费。
五百万的硬件啊。就搁那闲置。说出来都是泪。
最容易被忽略的研发盲区:数据质量的隐形熵增
什么是隐形熵增?说白了就是,你的数据看起来全,量也够,但是每天都在悄悄变“脏”,你不盯着,过不了半年,整个数据体系就乱了。
上游业务改个字段,不通知你。第三方合作方换了日志格式,偷偷的。用户埋点加了新参数,原来的规则不兼容。这些小事,研发的时候不做兜底,出问题就是灾难性的。
去年接触过一个做生鲜电商推荐的团队,花了八个月做大模型个性化推荐,上线前AB测试准确率比原来的模型高12个点,所有人都以为要爆了。结果一上线,推荐全乱了,推的全是用户从来不买的东西,一周转化率掉了快20%。
团队查了三天三夜,最后查到什么?第三方提供的用户地理位置标签,每周都会多出来十几个没提前声明的空值,研发的时候没做空值过滤的兜底,直接把整个特征矩阵给冲乱了。
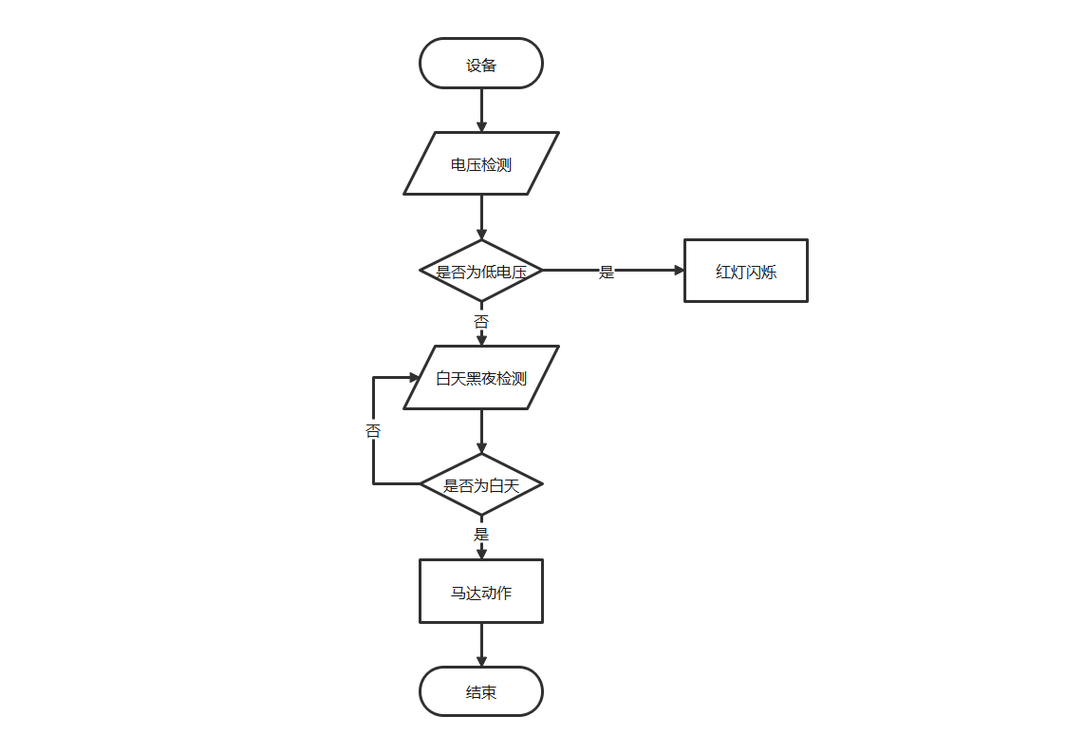 大数据脏数据检测流程示意图
很多团队现在都犯同一个错:把九成资源砸在算法模型上,只有不到一成的精力投在大数据治理的研发上。完全搞反了顺序对吧?
说实话,现在市场上不缺会调参的算法工程师,缺的是能把数据体系搭稳,能控制住隐形熵增的大数据研发。你把这块做透了,你的模型效果就是比别人稳,成本就是比别人低,这东西骗不了人。
大模型时代,大数据技术研发的新机会在哪
 大模型时代,大数据技术研发的新机会在哪
不过话说回来,现在也不是全是坏消息。需求变了,新的机会也出来了。
原来大数据团队和AI模型团队是完全分开的,大数据研发把数据洗好整好,丢给模型团队,中间对接沟通就要耗好几天,碰到需求变更,重新出数据又要等。现在行业都在做数据-模型一体化研发,要求大数据层直接产出模型能用的向量特征,需求过来直接就能调,不用中间转一道手。
最近看顶会的新成果,很多有落地价值的研究都不是什么凭空蹦出来的全新理论,都是顺着这个需求来的。比如去年北大计算机系发的那篇动态多源特征更新的论文,就是解决大模型实时推理的时候,大数据特征抽取延迟高的问题,落地到实际业务里,延迟直接降了70%,服务器成本砍了一半,这才是真的有用的研发成果,不是炒概念。
现在很多创投圈的朋友开口闭口就是大模型,一提大数据研发就觉得是过气的传统业务,我每次听到都想乐。大模型训练要高质量数据,推理要实时特征,哪一步离得开大数据研发?没有扎实的大数据研发做底座,再牛的大模型都是空中楼阁,一推就倒。
有意思的是,最近半年我观察到,很多大厂都在悄悄扩招大数据研发岗,开出的总包比同等级的纯算法岗还高15%左右。说明大家都回过神来了,基础不牢,地动山摇,该补的课还是要补。
前阵子碰到位从大厂出来创业的研发负责人,他说他出来招人的第一个优先级,就是先招三个大数据研发,算法岗往后排。原来在大厂做项目吃过亏,九个算法大佬调参调半年,不如一个会搭数据体系的老兵一出手,问题直接解决了。
这件事我记到现在。
技术这行,从来都是谁把脏活累活做细,谁就能拿到真红利。那些追着热点跑,把所有筹码都压在聚光灯下的概念上的人,往往最后才发现,最赚钱的机会,就在聚光灯背后没人愿意蹲的脏坑里。