聊聊可靠性增长:从翻车到真香,工程师都做了啥?
说起可靠性增长,我想起几年前买的那台首批新能源车。简直是一部血泪史——头半年进了五次修理厂。车机黑屏、电池虚标、辅助驾驶幽灵刹车……那时候我天天在车友群吐槽,感觉自己就是个小白鼠。
但奇怪的是,过了一年多,同款车新出厂的竟然没啥毛病了。后来我才明白,这叫可靠性增长。说白了,就是产品刚出来时问题一堆,通过不断测试、收集数据、改进设计,让它慢慢变得皮实耐用的过程。不是神话,是工程实践中真实存在的规律。
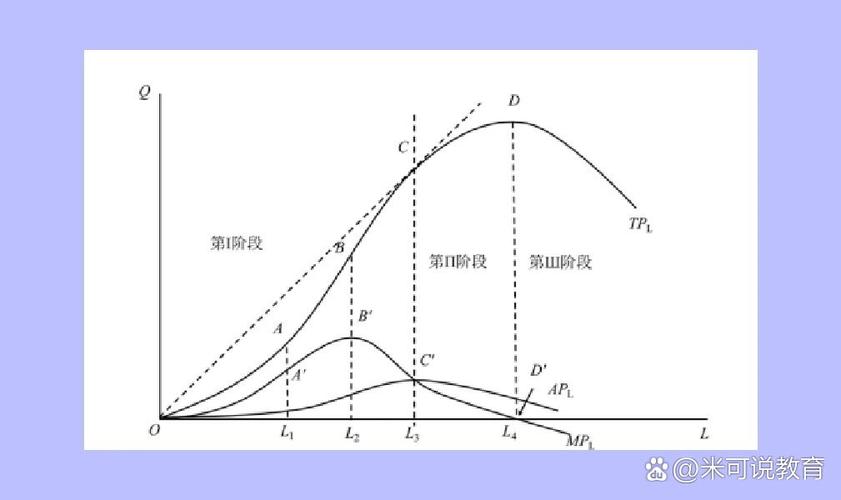 杜安模型双对数纸上的可靠性增长曲线
 汽车可靠性增长测试工程师检查故障部件
可靠性增长不是玄学,是数据驱动的迭代
很多人第一次听到“可靠性增长”,以为是种玄学——就像修仙,时间到了功力自然涨。其实完全不是那么回事。它背后有套严密的数学模型,典型的就是杜安模型和AMSAA模型。杜安模型最早是通用电气的一位工程师在1960年代分析飞机发动机故障数据时总结出来的,他发现累计故障率跟运行时间在双对数纸上呈一条直线,也就是说,随着时间推移,系统可靠性在以幂律形式改善。后来美军把这个方法用于武器系统研发,搞出了更精细的AMSAA模型,可以评估增长趋势、预测未来的故障间隔时间。 说实话,这些公式看着挺唬人。但对于工程师来说,它的价值就一句话:帮你判断当前的测试改进到底有没有效,还得测多久才能达到目标。 如果故障改善的速度太慢,那就意味着设计更改可能没抓到根因;如果曲线突然变陡,恭喜你,大概率是找到了一个关键的失效模式。我最烦的是那种纯粹为了凑测试时间而测试——没有失效分析、没有设计迭代,哪怕跑上一万小时,可靠性也不会增长分毫。杜安模型双对数纸上的可靠性增长曲线
现实里那些翻车与翻盘的故事,比电影精彩
可靠性增长这个事儿,做得好了是口碑逆袭,做不好就是灾难。想想当年某品牌手机Note7的电池门,就是典型反面教材——发布前可靠性增长测试没做到位,结果上市后炸成一片,最后全球召回、品牌形象砸得稀碎。不过也有正面例子:说一个我熟悉的,某自主品牌SUV,第一代车型刚出的时候底盘异响、车机死机,投诉率超高。但他们没急着推新款,而是沉下心把售后数据拉回来,一条条分析,搞了整整一年有针对性的改进测试——比如高寒高原的专项路试、电子元件加速寿命试验。第二代上市后,那感觉,简直像换了辆车,后来连续几年拿了细分市场口碑冠军。 这个过程,就是典型的可靠性增长:发现问题,找到根源,修改设计,再验证,周而复始。只不过,好的企业把这个循环做得更快、更狠。而烂企业呢?他们也会“增长”,但增长的是用户愤怒值。汽车可靠性增长测试工程师检查故障部件