当“高冷”科研成果飞入寻常百姓家:普惠技术推广的酸甜苦辣
上周,我花了三个晚上,终于让一台只有8GB内存的老旧笔记本跑起了70亿参数的大模型。说实话,当那个命令行界面跳出第一个像模像样的回答时,我差点叫出声来——这玩意儿几个月前还非得用专业显卡不可!然后我就开始想,那些窝在实验室里的科研成果,到底是怎么一步步变成你我能随手玩的工具的?这个过程,真不是把论文往GitHub一扔就完事。
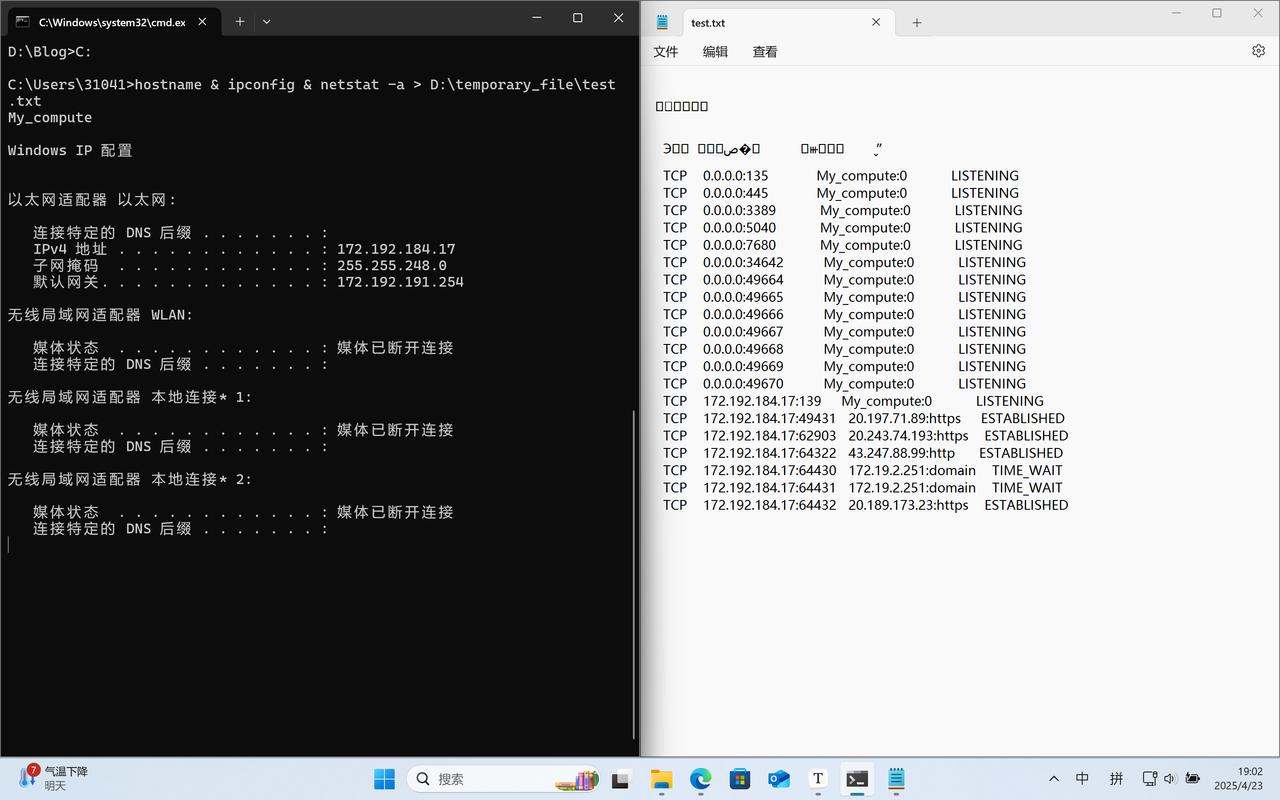 开源大模型本地运行命令行截图
这两年,大模型火得发烫,可热闹背后是巨大的算力鸿沟。动辄几十万张显卡的训练成本,让中小开发者只能干瞪眼。但变化在悄悄发生。比如llama.cpp这类项目,用纯C++重写了推理引擎,愣是把内存占用砍掉一半还多,量化精度损失小到可以忽略。还有前几天看到的PowerInfer,直接在手机CPU上跑起了10B级别的模型,速度居然不慢——这些技术突破,才是普惠的真正底座。不过话说回来,推广之路上,可踩过太多坑了。
从论文到产品,中间隔着一条“死亡谷”
我有一个朋友,是某AI实验室的工程师,他跟我吐槽过无数次。他们费劲做出一个训练加速算法,论文发了顶会,代码也开源了,但企业拿来根本用不了——因为那算法只适配了他们自己的特定硬件,换个显卡就差到离谱。他说:“我们搞科研的时候,追求的是极致的指标,可产业界要的是鲁棒性、易用性、兼容性。这中间的 gap,没人填。” 对,不是每项研究都该被直接推到用户面前,有些天生就适合待在实验室里发光发热。但那些真正有潜力改变的,往往被埋没在晦涩的文档和粗糙的代码里。
所以普惠技术推广的第一步,是让科研成果学会“说人话”。不是发新闻稿说“我们达到了SOTA”,而是告诉你:这个东西能干啥,需要什么条件,可能在哪出岔子。就像那个用Python写推理框架的哥们,他把文档写得像生肉番剧的弹幕——虽然杂乱,但一看就懂。结果star数瞬间破万。你看,大家不是不感兴趣,是怕被专业名词砸晕。
 低代码AI开发平台可视化操作界面
谁在真正做“翻译”工作?
 谁在真正做“翻译”工作?
技术推广需要一批“杂食动物”。他们得懂底层原理,还得会用通俗语言讲故事,甚至要能画出灵魂风格的架构图。我见过最感动的一个例子,是一个搞物理的博士生,自己写了一套教材,教文科生用AI做文本分析。他不用“embedding”这个词,说那是“把词语变成一串数字”;不讲transformer架构,而是画小人推箱子——能跨过知识诅咒的人,太稀罕了。不过讽刺的是,这类工作通常不算学术成果,评职称没用。因此,许多优秀的“翻译官”只能凭兴趣在做,平台寥寥。
不过,也有公司看到了机会。比如Hugging Face,它把模型分享变得像发微博一样简单,顺便带火了一个概念叫“SaaS for ML”——它自己就是个巨大的技术推广引擎。但话说回来,平台是有了,内容还得靠人填。最近有几个开源社区在做“模型测评直播”,找来真实用户当场提问,把那些参数量巨大但回答烂透的模型直接挂出来嘲讽。观众看得哈哈大笑,转发量惊人。不得不说,这种带着烟火气的展示,比任何技术白皮书都有说服力。
别让“普惠”成了新的内卷口号
 别让“普惠”成了新的内卷口号
昨天在即刻上刷到一条动态,一个创业者说:“现在不是缺技术,是缺把技术塞进具体场景里的傻瓜式工具。” 我特别赞同。你看那些真正普及开的东西——微波炉、智能手机、微信——哪个不是把复杂留给自己,把简单丢给用户?但如今有些所谓的“普惠”,其实是把一堆半成品API扔出来,然后指望开发者自己拼七巧板。好比给你一堆乐高积木,却不给图纸,还怪你搭不出城堡。真有点哭笑不得。
另外让我有点担忧的是,部分人把“技术推广”搞成了KPI游戏。比如社区里一定要刷到多少万开发者,下载量破亿,不管是不是有人真的在用。我们最需要的,可能是放慢脚步,聆听那些真实的、磕磕绊绊的使用反馈。记得有个做边缘计算的小团队,给厂区工人培训用AI质检系统,结果发现一大半人连触屏都不熟。他们后来把界面改成大按钮、语音交互,还配了方言包。这才是接地气啊。
说到底,技术推广不是高高在上的施舍,而是一场手拉手的笨拙共舞。我们需要更多愿意蹲下来的人,把那些尘封的论文变成一个个可执行的笔记本,把高深的算法打包进一个双击就启动的EXE。至于那些还在实验室里打磨的成果,别急,慢慢来,好东西值得翻山越岭。对了,最后推荐一个最近觉得挺好玩的东西——ChatGPT的代码解释器,它让数据分析门槛低到令人发指,也算是一种另类的普惠吧。可以去试试,就输入“画个爱心形状的概率分布图”,看看它会不会给你惊喜。