高效能计算平台:科研狗背后的算力黑箱
前两天跟一个搞材料模拟的朋友聊天,他抱怨说组里的服务器又爆了。对,就是物理意义上“爆”的那种——电源短路,焦味飘满实验室。我问你们咋不上云?他白我一眼:“贵啊,我们那点经费,跑一次全原子模拟,几千核心,跑两周,你算算?”
说实话,这种事儿在科研圈太常见了。一边是嗷嗷待哺的算力需求——深度学习训练、基因组装、流体力学模拟,动辄就要PB级的数据吞吐;另一边是现实里吱呀作响的老旧集群,排队排到天荒地老。高效能计算平台,这词儿听着高大上,说白了就是想让这群聪明脑袋别再跟硬件较劲。
不过话说回来,这几年变化真的快。
以前搞计算,基本就是攒服务器。自己装机,自己布线,自己修。我读博那会儿,实验室有个神人,外号“张电工”,因为集群三天两头出问题,他愣是被逼成了硬件高手。现在想想真是心酸又好笑——我们的本行可是做计算的啊,怎么大半时间在折腾机器?
云化,或者更准确地说,算力服务化,算是把这层皮给剥开了。你不用管底层是几千块CPU还是几百张GPU,只要在网页上提交作业,它就在那儿跑。国家超算中心,各地的人工智能计算中心,还有商业云,基本都搞成了高效能计算平台。界面是个web portal,后端连着一大堆黑压压的机柜。你传个脚本上去,它能自动调度,并行优化,跑完给你发个邮件,完事儿。
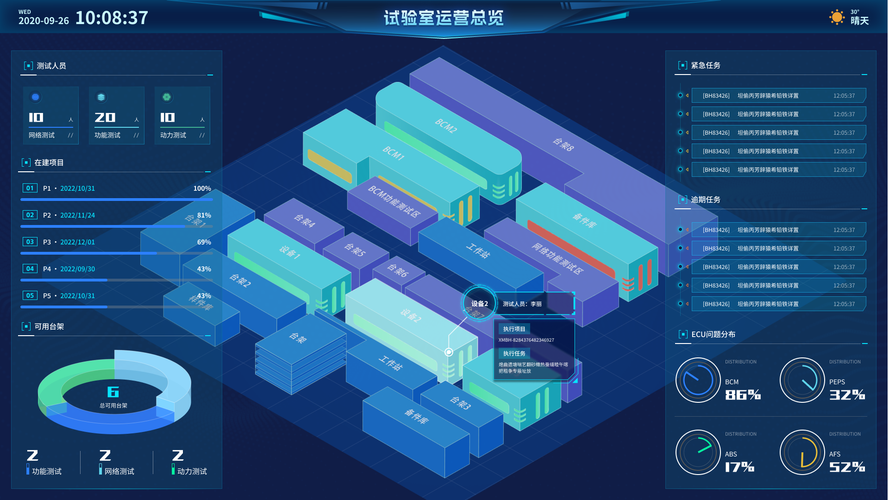 科研人员访问高效能计算平台web界面
但这真的省心了吗?也不全是。老问题刚去,新麻烦就来了。比如容器化,现在几乎所有平台都支持Docker,但你得把自己的环境打包好,镜像动辄几十GB,上传慢得要死。有一次我上传一个定制好的Pytorch镜像,卡在99%上,最后竟然超时了——那一刻我简直想把键盘吞了。
 异架构芯片混战,开发体验依然是地狱
算力硬件现在五花八门。英伟达的GPU依然称霸,但国产加速卡、FPGA、甚至存算一体芯片也在冒头。高效能计算平台为了展示自己的“异构调度能力”,恨不得把所有硬件都挂上去。某次我参加一个超算会议,看到某平台宣传接入了六种加速器,我心里只冒出一个念头:适配起来要命。
这是实话。科学研究用的软件,很多是多年的老代码,比如VASP、GROMACS这些第一性原理或分子动力学程序,当初只针对x86和CUDA优化。你要把它搬到RISC-V的芯片上?嗯,祝你好运。除非平台提供源码级的自动编译和优化,否则“异构”只是营销噱头。有个朋友做材料计算的,他们组买的机时,指明只要N卡,其他再便宜也不碰,因为折腾不起。
不过话说回来,有些领域倒是爱上了这种多样性。比如AI推理,在FPGA上跑,能效比真的高。如果你的模型正好是CNN一类,用Xilinx的加速器,功耗可能只是GPU的零头。高效能平台如果能做到对用户透明,自动选择最优硬件,那才叫真本事。可惜现在多是半自动的,你让系统选,它可能给你派个慢吞吞的CPU节点,就因为GPU队列满了。你能怎么办?只能学一点调度策略,自己写约束。
玩高效能计算,永远绕不开调度系统和作业脚本。SLURM、PBS,这些都是命令行下的恐龙,看着那堆命令就觉得,这玩意儿居然还活着。写一个SLURM脚本,申请资源,加载模块,设置环境变量,一行行跟天书一样。新人经常犯的错误是直接把笔记本上的代码扔上去跑,然后 node 就死了,因为没限制内存,把别的用户也挤炸了。然后管理员一封邮件过来,全员通报。
所以,友好的平台现在都搞应用模板,有点像手机上的快捷指令。你选“TensorFlow单机多卡训练”,它自动生成脚本,你只要改数据路径就行。这个特别香。我强烈推荐大家用起来,别自己从零写,浪费时间。
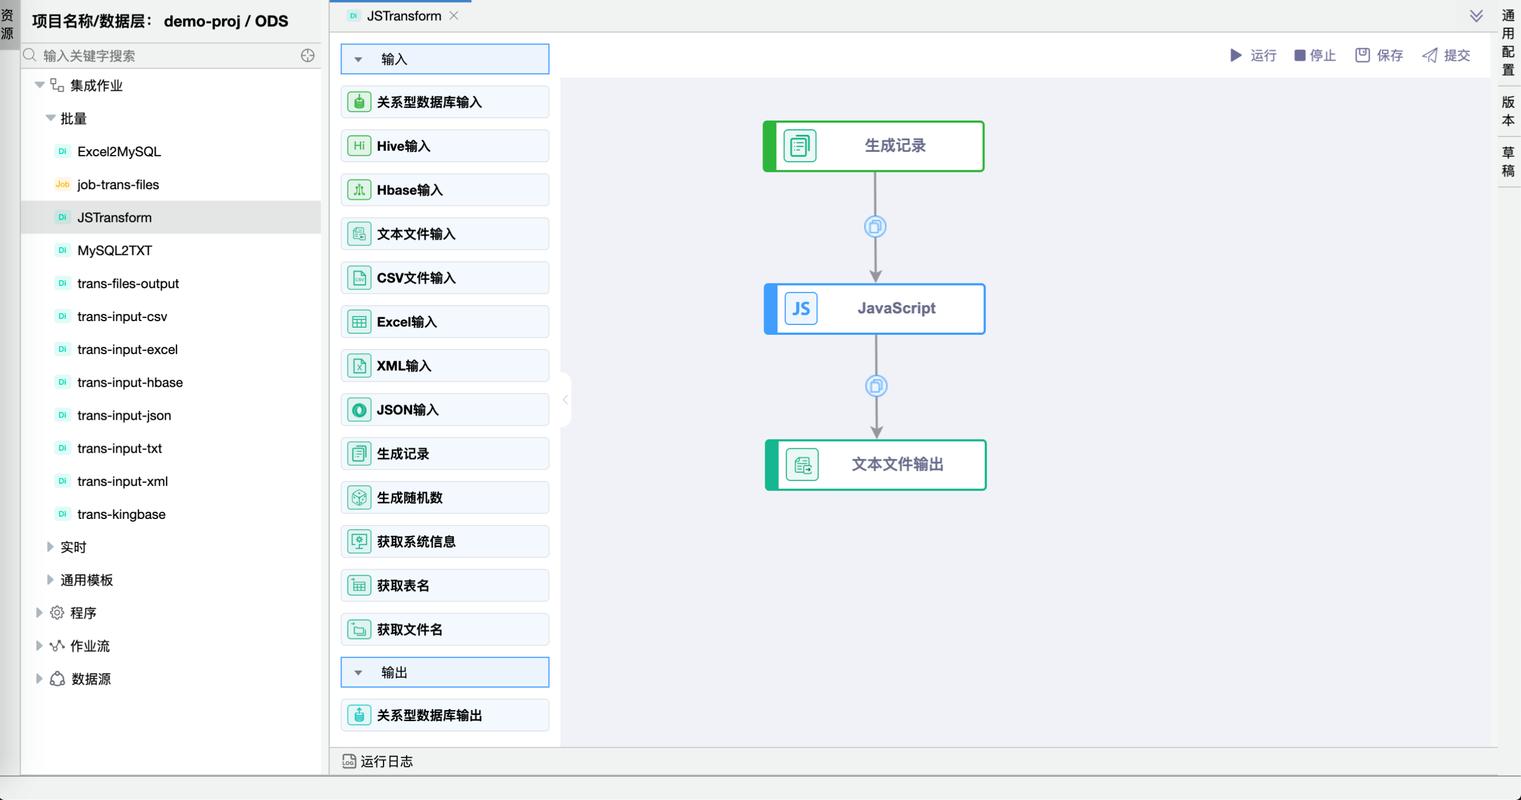 高效能计算平台作业提交脚本示例
说到软件,另一个痛点是科学软件的许可。好多商业软件,像MATLAB、ANSYS,许可贵得离谱,而且严格限制核数。你花大钱买了一个高效能平台的机时,结果发现软件许可只有单机8核,那你上平台的意义何在?就为了跑得快?快不了啊,被许可掐脖子。所以开源在科研计算领域才会这么火爆,OpenFOAM、Quantum ESPRESSO这些,虽然配置麻烦,但至少你不用数着核跑,上千核并行走起,效率虽然会掉,但总算能算。
吐槽归吐槽,高效能计算平台对科研的价值,是实打实的。新冠疫情那会儿,蛋白结构预测,疫苗设计,多少计算是在这种平台上昼夜不停跑的。去年AlphaFold2开源,我有个做结构生物学的朋友,兴奋得凌晨三点给我发消息。他们实验室没有GPU,第一次接触蛋白质折叠,全靠国家超算中心的免费开放资源。他说,点下提交那一刻,感觉像把信投进了未来。
这就是平台的意义吧,让算力民主化。希望以后这些平台少来点幺蛾子,多干点人事儿。别整那些花里胡哨的监控大屏,先把作业队列的速度提上去,行不?
说实话,这种事儿在科研圈太常见了。一边是嗷嗷待哺的算力需求——深度学习训练、基因组装、流体力学模拟,动辄就要PB级的数据吞吐;另一边是现实里吱呀作响的老旧集群,排队排到天荒地老。高效能计算平台,这词儿听着高大上,说白了就是想让这群聪明脑袋别再跟硬件较劲。
不过话说回来,这几年变化真的快。
从“买机器”到“买算力”,像点外卖一样简单?
以前搞计算,基本就是攒服务器。自己装机,自己布线,自己修。我读博那会儿,实验室有个神人,外号“张电工”,因为集群三天两头出问题,他愣是被逼成了硬件高手。现在想想真是心酸又好笑——我们的本行可是做计算的啊,怎么大半时间在折腾机器?
云化,或者更准确地说,算力服务化,算是把这层皮给剥开了。你不用管底层是几千块CPU还是几百张GPU,只要在网页上提交作业,它就在那儿跑。国家超算中心,各地的人工智能计算中心,还有商业云,基本都搞成了高效能计算平台。界面是个web portal,后端连着一大堆黑压压的机柜。你传个脚本上去,它能自动调度,并行优化,跑完给你发个邮件,完事儿。
科研人员访问高效能计算平台web界面
但这真的省心了吗?也不全是。老问题刚去,新麻烦就来了。比如容器化,现在几乎所有平台都支持Docker,但你得把自己的环境打包好,镜像动辄几十GB,上传慢得要死。有一次我上传一个定制好的Pytorch镜像,卡在99%上,最后竟然超时了——那一刻我简直想把键盘吞了。
异架构芯片混战,开发体验依然是地狱
异架构芯片混战,开发体验依然是地狱
算力硬件现在五花八门。英伟达的GPU依然称霸,但国产加速卡、FPGA、甚至存算一体芯片也在冒头。高效能计算平台为了展示自己的“异构调度能力”,恨不得把所有硬件都挂上去。某次我参加一个超算会议,看到某平台宣传接入了六种加速器,我心里只冒出一个念头:适配起来要命。
这是实话。科学研究用的软件,很多是多年的老代码,比如VASP、GROMACS这些第一性原理或分子动力学程序,当初只针对x86和CUDA优化。你要把它搬到RISC-V的芯片上?嗯,祝你好运。除非平台提供源码级的自动编译和优化,否则“异构”只是营销噱头。有个朋友做材料计算的,他们组买的机时,指明只要N卡,其他再便宜也不碰,因为折腾不起。
不过话说回来,有些领域倒是爱上了这种多样性。比如AI推理,在FPGA上跑,能效比真的高。如果你的模型正好是CNN一类,用Xilinx的加速器,功耗可能只是GPU的零头。高效能平台如果能做到对用户透明,自动选择最优硬件,那才叫真本事。可惜现在多是半自动的,你让系统选,它可能给你派个慢吞吞的CPU节点,就因为GPU队列满了。你能怎么办?只能学一点调度策略,自己写约束。
软件生态:不说人话的文档和救命的开源
玩高效能计算,永远绕不开调度系统和作业脚本。SLURM、PBS,这些都是命令行下的恐龙,看着那堆命令就觉得,这玩意儿居然还活着。写一个SLURM脚本,申请资源,加载模块,设置环境变量,一行行跟天书一样。新人经常犯的错误是直接把笔记本上的代码扔上去跑,然后 node 就死了,因为没限制内存,把别的用户也挤炸了。然后管理员一封邮件过来,全员通报。
所以,友好的平台现在都搞应用模板,有点像手机上的快捷指令。你选“TensorFlow单机多卡训练”,它自动生成脚本,你只要改数据路径就行。这个特别香。我强烈推荐大家用起来,别自己从零写,浪费时间。
高效能计算平台作业提交脚本示例
说到软件,另一个痛点是科学软件的许可。好多商业软件,像MATLAB、ANSYS,许可贵得离谱,而且严格限制核数。你花大钱买了一个高效能平台的机时,结果发现软件许可只有单机8核,那你上平台的意义何在?就为了跑得快?快不了啊,被许可掐脖子。所以开源在科研计算领域才会这么火爆,OpenFOAM、Quantum ESPRESSO这些,虽然配置麻烦,但至少你不用数着核跑,上千核并行走起,效率虽然会掉,但总算能算。
吐槽归吐槽,高效能计算平台对科研的价值,是实打实的。新冠疫情那会儿,蛋白结构预测,疫苗设计,多少计算是在这种平台上昼夜不停跑的。去年AlphaFold2开源,我有个做结构生物学的朋友,兴奋得凌晨三点给我发消息。他们实验室没有GPU,第一次接触蛋白质折叠,全靠国家超算中心的免费开放资源。他说,点下提交那一刻,感觉像把信投进了未来。
这就是平台的意义吧,让算力民主化。希望以后这些平台少来点幺蛾子,多干点人事儿。别整那些花里胡哨的监控大屏,先把作业队列的速度提上去,行不?