量子算法研究:当理论遇上现实,我们都太天真了
说实话,每次看到科技头条上那些“量子计算将改变世界”的标题,我就想翻白眼。不是我不信,是现实太骨感。去年参加一个会议,某大厂高管在台上激情澎湃地画饼,说五年后量子算法会彻底颠覆药物研发。底下我旁边的哥们悄悄嘀咕:“他连量子比特的相干时间是多长都不知道吧?” 我差点把咖啡喷出来。
不过话说回来,量子算法研究这几年确实热闹,比菜市场还热闹。问题是,热闹归热闹,能落地的有几个?我前阵子读一篇 Nature 上的论文,讲利用超导量子处理器实现量子优越性,结果一看,解决的是一个精心设计的、没啥实际用途的数学问题。这就像你造了一辆超级跑车,却只让它跑个直线加速,然后宣布:“看,我比自行车快!” 对,是快,但你能送快递吗?
好吧,扯远了。咱们还是来聊聊真正让人兴奋又头疼的东西。
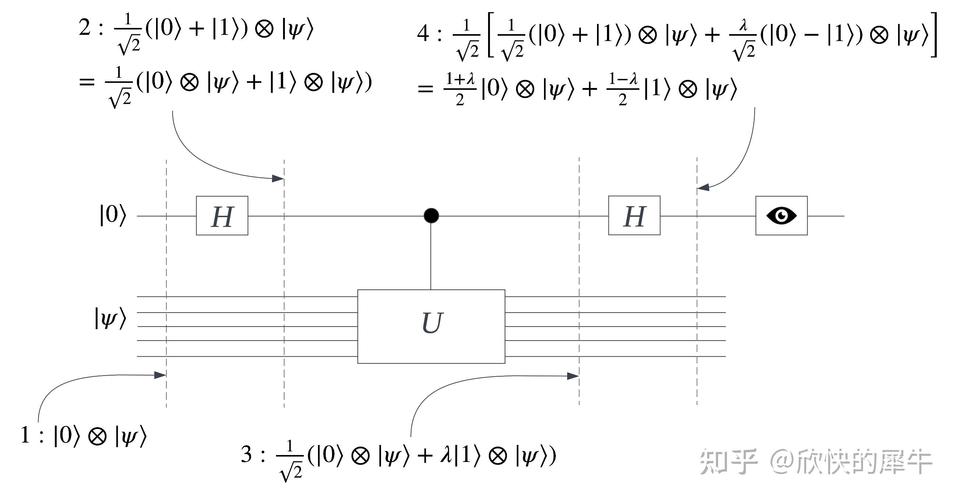 Shor算法分解质因数量子线路图
但现实是,我们离那个“足够强大”还差着十万八千里。目前的量子硬件,连个数百位的数都分解不了——这还得看相干时间和门保真度。记得有团队声称用 Shor 算法分解了 21,对,你没看错,21 = 3 × 7。这成果在圈内被调侃为“21的胜利”。但你说它没用吧,它又是原理验证。真纠结。
然后有人提出后量子密码(PQC),就是研究能抗量子攻击的加密算法。美国 NIST 正在搞标准化,国内也在跟进。不过,我总觉得这事儿有点“道高一尺魔高一丈”的味道。量子算法在进化,抗量子密码也在进化。就像猫鼠游戏。只是苦了我们这些做工程的——刚适应一套标准,又得换。
 噪声中等规模量子设备上的VQE算法示意图
但实际用起来,问题一堆。首先,那个叫“贫瘠高原”(Barren Plateau)的现象——优化空间的梯度随量子比特数呈指数减小,导致参数训练根本训不动。很多做理论的说“我们发现了解决贫瘠高原的新方法”,但一到实验就露馅。我有个朋友在实验室折腾了大半年 VQE 算分子基态,最后测出的能量比经典方法还差,噪声全淹没了。他自嘲:“这哪是量子优势,这是量子劣势。”
更怪的是,有些论文选的问题天生适合 VQE,就跑出好结果,然后就大肆宣传。这不是典型的 cherry-picking 吗?学术界的自欺欺人有时候真让人无力。
不过,也不是全无希望。最近有团队利用误差缓解技术,让 VQE 精度提高了些。还有人搞硬件 co-design,设计专门针对某些分子的 Ansatz。我觉得这事得务实,别动不动就想算个蛋白质折叠,先从几个原子的小分子开始。路要一步步走,对吧。
 量子机器学习处理MNIST数据对比经典方法
对了,最近有个方向挺有意思,叫做“量子-经典混合算法”,其实还是变分那一路,但更多关注在经典部分做文章。比如把量子电路当作一个黑箱特征映射,然后用强大的经典模型在后处理。这算是一种务实,但也容易被人质疑“你这还叫量子算法吗?” 不纠结名字的话,能解决问题就好。
Shor 算法:悬在密码学头上的达摩克利斯之剑
这可能是量子算法里最出名的了。1994年,Peter Shor 提出这个算法时,估计他自己都没想到,这玩意儿会让整个安全领域失眠几十年。简单讲,Shor 算法能高效分解大整数,而现在的公钥加密,比如 RSA,就是建立在大整数分解难的基础上。一旦量子计算机足够强大,现有的加密体系瞬间崩塌。多么恐怖的潜力。Shor算法分解质因数量子线路图
但现实是,我们离那个“足够强大”还差着十万八千里。目前的量子硬件,连个数百位的数都分解不了——这还得看相干时间和门保真度。记得有团队声称用 Shor 算法分解了 21,对,你没看错,21 = 3 × 7。这成果在圈内被调侃为“21的胜利”。但你说它没用吧,它又是原理验证。真纠结。
然后有人提出后量子密码(PQC),就是研究能抗量子攻击的加密算法。美国 NIST 正在搞标准化,国内也在跟进。不过,我总觉得这事儿有点“道高一尺魔高一丈”的味道。量子算法在进化,抗量子密码也在进化。就像猫鼠游戏。只是苦了我们这些做工程的——刚适应一套标准,又得换。
变分量子算法:近期的“救命稻草”吗?
因为容错量子计算机遥遥无期,大家就把目光转向了含噪声的中等规模量子(NISQ)设备。变分量子算法(VQA)就是在这个背景下火起来的。其中 VQE(变分量子本征求解器)和 QAOA(量子近似优化算法)是明星。它们的想法很巧妙:用一个参数化的量子电路,让经典计算机去优化参数,利用量子态做些经典难算的事情。听上去完美,对吧?噪声中等规模量子设备上的VQE算法示意图
但实际用起来,问题一堆。首先,那个叫“贫瘠高原”(Barren Plateau)的现象——优化空间的梯度随量子比特数呈指数减小,导致参数训练根本训不动。很多做理论的说“我们发现了解决贫瘠高原的新方法”,但一到实验就露馅。我有个朋友在实验室折腾了大半年 VQE 算分子基态,最后测出的能量比经典方法还差,噪声全淹没了。他自嘲:“这哪是量子优势,这是量子劣势。”
更怪的是,有些论文选的问题天生适合 VQE,就跑出好结果,然后就大肆宣传。这不是典型的 cherry-picking 吗?学术界的自欺欺人有时候真让人无力。
不过,也不是全无希望。最近有团队利用误差缓解技术,让 VQE 精度提高了些。还有人搞硬件 co-design,设计专门针对某些分子的 Ansatz。我觉得这事得务实,别动不动就想算个蛋白质折叠,先从几个原子的小分子开始。路要一步步走,对吧。
量子机器学习:是泡沫还是未来?
量子机器学习(QML)这个领域,泡沫绝对不小。每次看到标题“量子神经网络超越经典深度学习”我就血压上升。点进去一看,往往是在合成数据集上,跟一个未经调优的经典算法比。要么就是量子核方法,理论看起来很漂亮,一部署到真实数据上,效果跟抽风一样不稳定。 不过,有几篇 work 我倒是挺欣赏。比如用张量网络做量子启发式经典算法,虽然严格说这不是量子算法,但蹭了量子的概念,在推荐系统上效果不错。还有用量子电路做生成模型的,量子玻恩机,前景有但极不稳定。说实话,我个人觉得 QML 在短期内能突破的,可能是那些数据本身就有量子特性的任务,比如量子化学、量子多体问题,而不是去和经典 MNIST 较劲。量子机器学习处理MNIST数据对比经典方法
对了,最近有个方向挺有意思,叫做“量子-经典混合算法”,其实还是变分那一路,但更多关注在经典部分做文章。比如把量子电路当作一个黑箱特征映射,然后用强大的经典模型在后处理。这算是一种务实,但也容易被人质疑“你这还叫量子算法吗?” 不纠结名字的话,能解决问题就好。