计算机视觉技术:从菜鸟到大佬,多少坑还没填?
前几天开车,导航突然喊‘前方有行人’,我一看,路边确实有个人,但他在人行道上。这种‘过度警惕’我倒不讨厌,比没看到强。不过话说回来,这背后就是计算机视觉技术——它得从像素里把行人扒出来,还得判断他会不会突然横穿。挺难的。
摄像头看到的,远比你想象的脆弱
你想想,摄像头拍到的是一堆数字,红的绿的蓝的,计算机得从中看出是猫是狗,是车道线,甚至读出表情。这中间要经过层层抽象。早期用卷积神经网络,一层层提取边缘、纹理、部件。我当年学卷积时,被那堆stride、padding折腾得够呛,心想这玩意真能有用?后来看到AlexNet那篇论文,才服了。现在Transformer大行其道,直接把图像打成patch,像处理语言一样处理图像。说实话,我第一次看到ViT(Vision Transformer)的效果时,心里骂了句:CTMD,这也行?(请原谅我的粗鲁)因为以前总觉得图像是有空间结构的,怎么能当序列?结果人家效果还更好。但你以为这就稳了?计算机视觉有个很搞笑的命门——对抗样本。你在停车标志上贴几个小贴纸,人类看还是停车标志,算法可能就认成限速100。这可不是实验室玩具,关系自动驾驶安全。研究人员曾用几张贴纸让特斯拉把路牌认错。所以,摄像头看到的和我们不一样,它看到的是一组脆弱得多的统计规律。
 对抗样本导致停车标志误识别示意图
这种脆弱性根源在于,模型学到的不是真正的‘概念’,而是像素和标签之间的关联。只要关联被破坏,它就懵了。不过话说回来,这几年在鲁棒性上确实有进展,用数据增强、对抗训练,但就像打地鼠,这边压下去那边又冒出来。
大模型带来的“啊哈时刻”
转机来自哪里?大模型。你如果去年没关注计算机视觉,肯定错过了SAM(Segment Anything Model)。这玩意儿简直...怎么说呢,就像朋友圈里那个啥都会的朋友。你点一下鼠标,它就能把图片中的某个物体精准地抠出来,管它是猫是狗还是根本没见过的玩意儿。以前的模型得在特定数据集上训练,分割猫就得标注几千张猫图。SAM呢?号称零样本分割,因为喂了10亿个掩码。这就把视觉任务从‘定制化’往‘通用化’推了一大步。
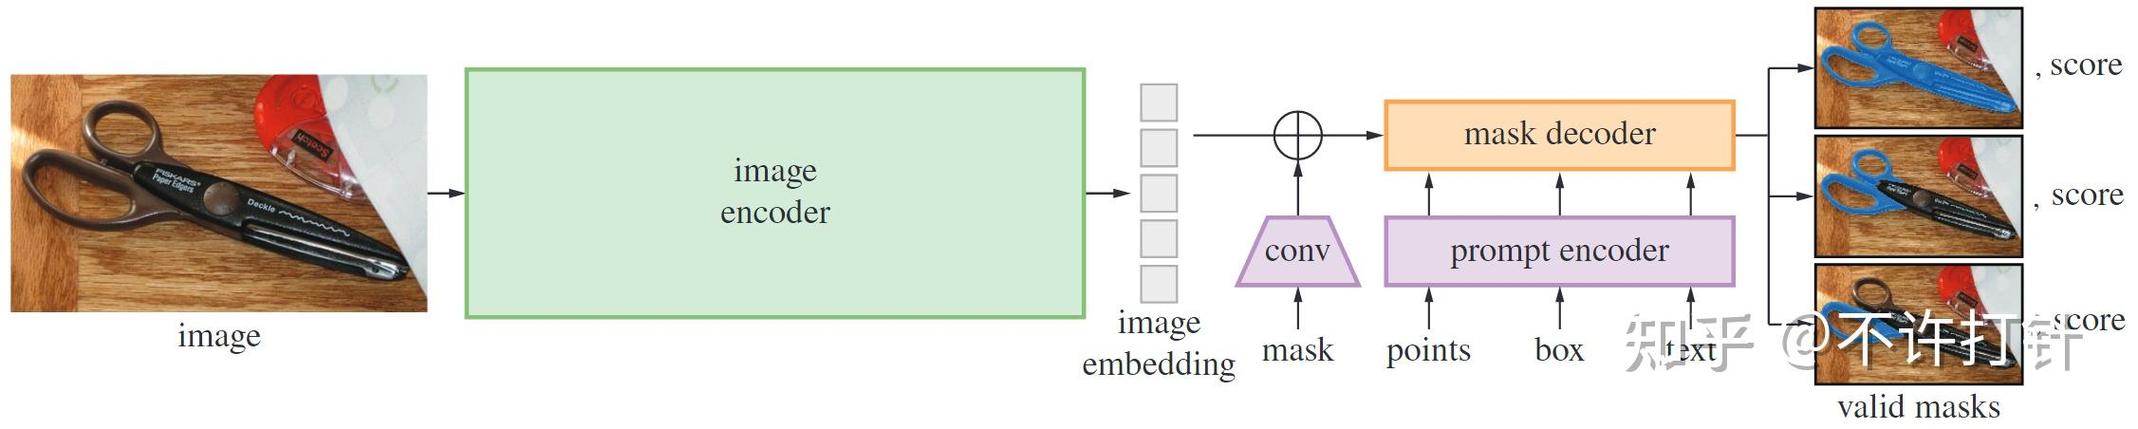 Segment Anything模型交互式分割物体示例
然后是多模态。CLIP那种模型,把文本和图像拉到一个空间里,于是你可以用语言告诉计算机视觉:‘帮我找出那只正在睡觉的橘猫’,它就能懂。这不再是传统的目标检测,而是语义理解。我前段时间玩Stable Diffusion,输入‘漂浮在太空中的中式亭台楼阁’,出来的图让我呆了——计算机视觉技术竟然能创造它没见过的场景了。这是联想,是组合,不再是简单的识别。当然,这种生成模型也会犯蠢,比如画出六根手指的手,或者把猫塞进杯子里导致身体错乱。但进步速度惊人。就在上个月,我还看到论文用扩散模型做视频预测,生成连贯的动作,开始有世界模型的意味了。
落地的坑,远比论文里的多
 落地的坑,远比论文里的多
好了,夸了半天,该说说坑了。计算机视觉技术落地,真不是刷几个SOTA指标那么简单。我有个朋友在工厂做缺陷检测,他告诉我,算法在实验室准确率99.9%,一到产线变95%——因为灯光变了,或者产品来了个新批次。数据漂移(Data Drift)是家常便饭。还有长尾问题,现实世界总有一些奇葩样本,你永远收集不全。比如自动驾驶,路上突然跑出一只鸵鸟(别笑,南非真有这种案例),模型直接当成不明物体略过?那可不行。而且,数据偏见也是个大问题。人脸识别在深色皮肤上的准确率一直受诟病。这不是技术不行,是数据分布不均。技术从来不是中立的,它折射了采集者的盲区。还有隐私问题,遍地摄像头,计算机视觉让‘匿名’变得脆弱。你戴着口罩也能被步态识别认出来。对吧,技术在进步,伦理也得跟上。
还有一个我特别想吐槽的:很多论文指标漂亮,但根本不敢开源模型,或者只给个半成品。复现起来一堆坑。浪费研究者时间。不过社区也在反击,Papers with Code,OpenReview,推动透明化。好现象。
计算机视觉技术,到底会走向哪里?也许某天它会像电力一样,无处不在却又无人察觉。但在那之前,还有得折腾。