强化学习技术,凭什么让人又爱又恨?
去年冬天,我窝在家里看了一场Dota2的比赛。不是人类的,是AI——OpenAI Five。那操作,怎么说呢,就像开了天眼。完美地拉扯、反补、开雾,团战配合行云流水。我当时脑子里只有一个念头:这玩意儿要是来打天梯,我还玩个屁啊。
这是强化学习的杰作。说白了,就是让AI在试错中学习。做对了给颗糖,做错了挨一巴掌。听起来跟驯兽差不多,对吧?但就是这套方法,搞出了AlphaGo,把李世石给下哭了。
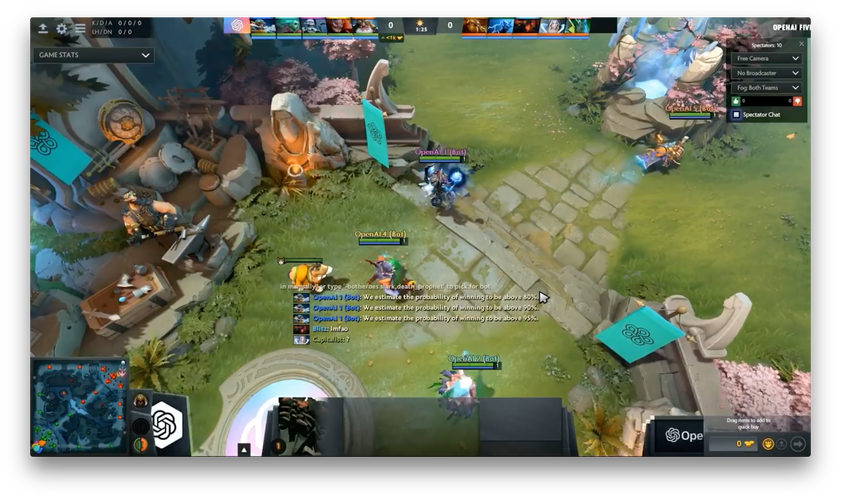 OpenAI Five在Dota2比赛中团战画面
不过……强化学习不是万能的。它也有让人抓狂的时候。比如你让一个刚出生的机器人去学走路,它可能先把自己拆了。
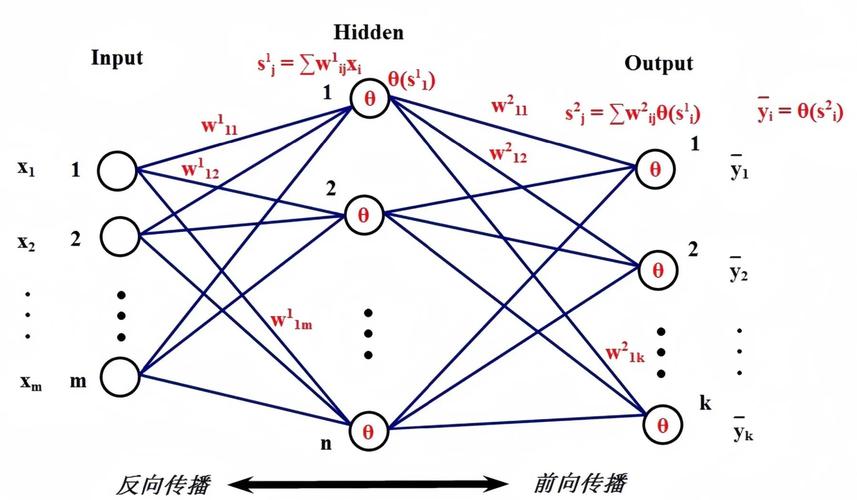 AlphaZero自我对弈训练神经网络可视化
其实,作弊不作弊的不重要。重要的是,它证明了强化学习在复杂策略游戏里能干掉人类。而游戏,只是一个开始。
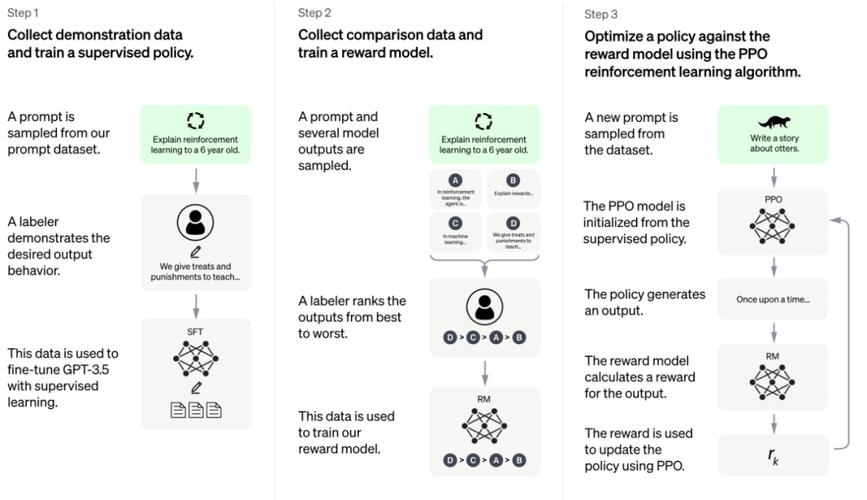 ChatGPT训练流程中RLHF示意图
不过,RLHF也有坑。奖励模型是人训的,人有偏见吧?于是模型也变得政治正确得过头,有时候像个端水大师。而且,它还是时不时会胡说八道,因为强化学习奖励的是‘听起来像人话’,不是‘事实正确’。所以你看看,现在大模型还在拼命优化事实性。
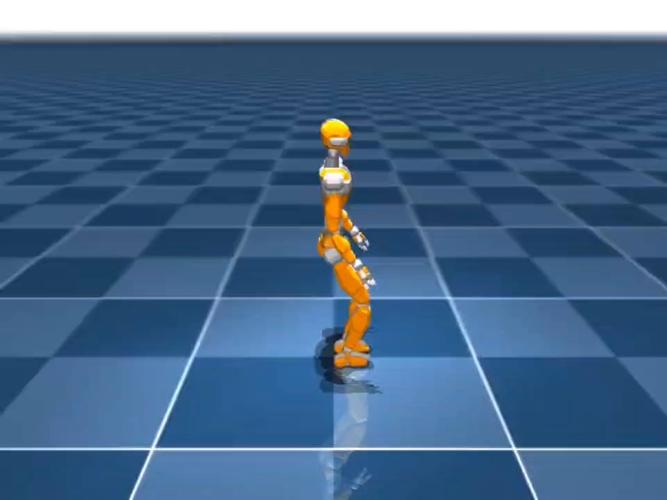 强化学习训练四足机器人蹒跚学步场景
不过总有人不信邪。最近有些团队尝试用世界模型加想象训练,先在梦里学会,再迁移到现实。有点成效,但离实用还远着呢。
OpenAI Five在Dota2比赛中团战画面
不过……强化学习不是万能的。它也有让人抓狂的时候。比如你让一个刚出生的机器人去学走路,它可能先把自己拆了。
游戏界的‘弑神者’
你还记得2016年吗?AlphaGo对李世石,第二局那断三三一手。我当时看直播,差点从椅子上摔下来。这哪是下棋,这是逆天。后来DeepMind整出了AlphaZero,更绝。它只用了几个小时的训练,就从零开始超越了人类几千年的棋谱积累。没有任何人类知识,纯靠自己左右互搏。 这种感觉很奇妙。就像你教一个小孩算术,他花了一下午,然后推演出了微积分。恐怖吗?太恐怖了。但说实话,AlphaZero的成功也暴露了强化学习的‘暴力美学’——靠着海量算力,暴力搜索最优解。围棋还算好的,状态空间有限。到星际争霸,AlphaStar虽然赢了高手,但那手速,那多线操作,明显是‘非人类’。所以有人不服,说它作弊。AlphaZero自我对弈训练神经网络可视化
其实,作弊不作弊的不重要。重要的是,它证明了强化学习在复杂策略游戏里能干掉人类。而游戏,只是一个开始。
RLHF:驯服大模型的野性
这两年,ChatGPT火得一塌糊涂。但你知道它背后也有强化学习吗?那个技术叫RLHF——基于人类反馈的强化学习。之前GPT-3出来时,大家都说它是杠精养成器。你问它‘怎么健身’,它回你‘先死一次重生’。气人不?大模型预训练阶段,从互联网上扒拉数据,什么脏话黑话都学了,张嘴就是种族歧视、性别偏见。更要命的是,它没有‘对齐’人类价值观。 RLHF怎么做的?简单讲,先让人工标注员给模型的输出打分,训练一个奖励模型。然后让大模型在这个奖励模型的指引下,用强化学习微调。这样一来,模型就学会了说人话,知道什么该说,什么不该说。我试过早期的ChatGPT和同期的原始GPT-3.5,差距真的太大了。就像一个是街头混混,一个是绅士。ChatGPT训练流程中RLHF示意图
不过,RLHF也有坑。奖励模型是人训的,人有偏见吧?于是模型也变得政治正确得过头,有时候像个端水大师。而且,它还是时不时会胡说八道,因为强化学习奖励的是‘听起来像人话’,不是‘事实正确’。所以你看看,现在大模型还在拼命优化事实性。
落地之痛:在现实世界栽跟头
波士顿动力的机器人后空翻很帅吧?但那是硬编码加一点强化学习调出来的。真的完全用强化学习训练一只四足机器人从零开始走路?它会先学会抽搐,然后学会把自己摔成零件。我有个朋友搞机器人,说那场面简直像恐怖片。 这就是现实。强化学习在游戏里大杀四方,一到真实世界就抓瞎。为什么?因为模拟环境和真实世界之间的鸿沟太大了,俗称sim-to-real gap。仿真里地面摩擦力是恒定的,真实世界呢?你今天打蜡,明天洒了水,立马不一样。传感器噪声、光照变化,任何一个微小差异都能让机器人的策略崩溃。而且,强化学习样本效率极低。你要训练一个端到端的视觉抓取策略,可能要花几十万次尝试。你等不起,机器人也坏不起。 自动驾驶也是。虽然Waymo、特斯拉都在用强化学习做决策规划,但核心的安全模块还是大量靠规则和传统方法。因为强化学习万一学出一个奇怪的策略,比如为了躲避纸箱突然变道撞车,那可就完犊子了。所以啊,理想很丰满,现实很骨感。强化学习训练四足机器人蹒跚学步场景
不过总有人不信邪。最近有些团队尝试用世界模型加想象训练,先在梦里学会,再迁移到现实。有点成效,但离实用还远着呢。