那个通宵改代码的团队,真的成了!—记一支创新团队风采
凌晨三点,实验室的灯还亮着。小王盯着屏幕上跳动的曲线,突然大喊一声,把旁边打盹的老李吓了一跳。“成了!”他声音都在抖。屏幕上的预测曲线和实验数据几乎完美重合,这个他们熬了无数个夜才跑出来的AI模型,终于把某个靶点化合物的筛选时间从18个月压缩到了11天。老李揉揉眼睛,凑过去看,然后两个人像傻子一样在空荡荡的实验室里又笑又跳。
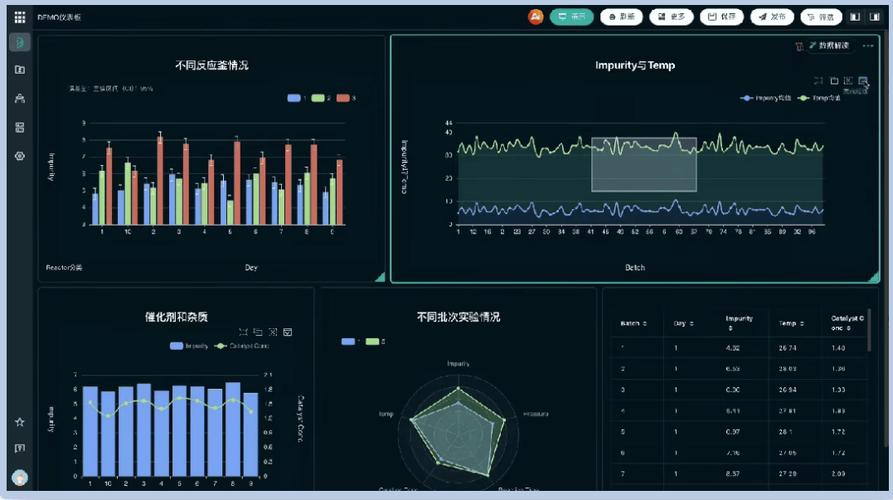 凌晨的AI药物研发实验室电脑屏幕曲线图
说实话,这种场景在科技新闻里你可能见多了,觉得老套。但真发生在自己身边,你才能感觉到那种——怎么说呢——就是突然觉得一切都有希望了的那种劲儿。这支团队叫“深维智药”,名字有点中二,但他们做的事很硬核:用AI设计新药。没错,不是辅助,是直接设计。这两年AI制药赛道都快被资本捧上天了,薛定谔、英伟达都在疯狂布局,可真正能把从头设计的分子推进到动物实验的,全球也没几家。他们就是其中之一。
于是他们做了个特冒险的决定:先把所有公开的化合物数据库都“喂”给模型,然后用一套自己发明的算法,让模型学会的不是结构,而是“病理反应指纹”。简单说,就是不看分子长啥样,只看它跟疾病靶点互动的模式。这个思路太野了,论文发出去被审稿人质疑了半年,差点毕不了业的学生急得直掉头发。不过话说回来,野路子有时候就是能杀出一条血路。2022年初,他们的第一代模型在虚拟筛选准确率上干翻了好几个国际大厂的平台,这时候行业才开始正眼看他们。
 科研团队围绕白板讨论分子结构草图
老赵那阵子天天泡在实验室,跟做实验的同事一起盯液相色谱。有一天他突然发现,模型预测的分子构象和实际溶液里的构象根本不是一回事儿——因为AI没考虑溶剂效应。你看,AI再聪明也还是缺了点儿物理直觉。他们只能回头改造模型架构,加入显式的溶剂化层,然后又花了一个月重新训练。直到某天晚上,那根期待已久的峰终于在色谱图上冒出来,大家才长出一口气。老赵说:“那一刻我才明白,失败不是成功之母,失败后的复盘才是。单纯失败,那就是失败他妈——老失败。” 行吧,这比喻挺糙的,但理不糙。
“数据会说谎,但患者不会。”她这句话后来成了团队的非正式格言。AI能给你漂亮的IC50值、完美的ADMET属性,可如果最后药价高得离谱、或者根本没法量产,那些数据就是一堆彩色泡沫。现在他们每做一个项目,都会专门考虑可及性指标,这玩意儿在AI模型里原本是没有的,是他们一点一点用真实世界的数据“教会”模型的。有时候我觉得,这才是创新最动人的地方——不是算法多炫酷,而是它真的能落到地上,砸出一个坑。
不过他们也确实在找差异化的路。比如最近他们开源了一个针对中枢神经系统疾病的小分子库,里面全是能穿透血脑屏障的候选化合物,这玩意儿可是制药界的老大难。开源那天,社区里炸了,GitHub的fork数一晚上过千。有人留言问:“你们不怕被抄吗?”他们回:“怕啥,我们迭代比你抄的速度快。” 这种自信,还真不是吹的。
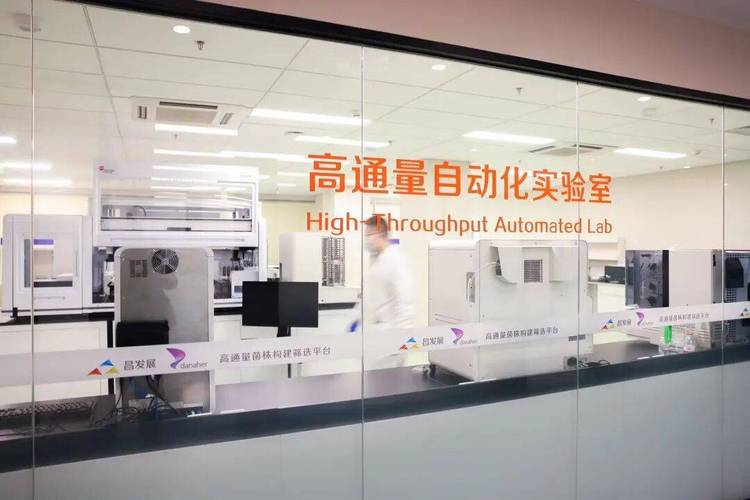 创新团队在实验室操作高通量筛选设备
前两天我去他们新搬的办公室,地方不大,但乱得很温馨。白板上全是画得歪歪扭扭的化学结构,角落里还堆着几箱红牛和泡面。小王给我展示他们最新的模型页面,得意地指着一个飙升的指标说:“看,这是我们上次那个失败项目的副产品,没想到在这儿用上了。” 失败项目都能变废为宝,这种团队,你让我怎么不信他们能成事儿?
说实话,写了这么多,我也想不出个漂亮的结尾。可能创新团队的风采本来就没什么固定模板,它就是一群不服输的人,在乱糟糟的真实世界里,一点点把不可能变成可能。对吧,有空你去他们实验室看看,那些亮到深夜的灯,比什么鸡汤都管用。
凌晨的AI药物研发实验室电脑屏幕曲线图
说实话,这种场景在科技新闻里你可能见多了,觉得老套。但真发生在自己身边,你才能感觉到那种——怎么说呢——就是突然觉得一切都有希望了的那种劲儿。这支团队叫“深维智药”,名字有点中二,但他们做的事很硬核:用AI设计新药。没错,不是辅助,是直接设计。这两年AI制药赛道都快被资本捧上天了,薛定谔、英伟达都在疯狂布局,可真正能把从头设计的分子推进到动物实验的,全球也没几家。他们就是其中之一。
从“不靠谱”的想法开始
回到三年前,团队创始人老赵还是个在高校里教生物信息的副教授。那时他参加了一个药企的闭门会,会上一个大佬吐槽:现在筛药就像大海捞针,砸几个亿可能捞上来一根塑料吸管。老赵心里一动,回来就拉着搞计算化学的师弟和学生开始捣鼓。他们最初的方案在投资人眼里简直就是闹着玩——“用生成式AI凭空造分子?你们连湿实验数据都没有,凭什么让模型学会规则?”老赵回忆起来还觉得憋屈:“当时有个投资人直接说,你们这项目啊,好比让一个从来没吃过汉堡的人去发明汉堡,最后可能搞出个带鱼腥味的馒头。你说气不气人?但冷静下来想想,人家说的也有道理。”于是他们做了个特冒险的决定:先把所有公开的化合物数据库都“喂”给模型,然后用一套自己发明的算法,让模型学会的不是结构,而是“病理反应指纹”。简单说,就是不看分子长啥样,只看它跟疾病靶点互动的模式。这个思路太野了,论文发出去被审稿人质疑了半年,差点毕不了业的学生急得直掉头发。不过话说回来,野路子有时候就是能杀出一条血路。2022年初,他们的第一代模型在虚拟筛选准确率上干翻了好几个国际大厂的平台,这时候行业才开始正眼看他们。
科研团队围绕白板讨论分子结构草图
那些差点放弃的至暗时刻
别以为有了算法就万事大吉。从虚拟到现实,隔着一条巨大的鸿沟。他们第一个从头设计的分子,在计算机里表现堪称完美——亲和力高、毒性低、合成路线也经济。结果到了实验室,合成出来的东西连目标蛋白的边都不沾。所有人傻眼了。连续三个月,每周例会都像追悼会,气氛压抑得能拧出水。搞化学合成的同事甚至开始怀疑人生:“我是不是把反应条件搞错了?要不就是纯度不够?”那种反复自我否定的感觉,太折磨人了。老赵那阵子天天泡在实验室,跟做实验的同事一起盯液相色谱。有一天他突然发现,模型预测的分子构象和实际溶液里的构象根本不是一回事儿——因为AI没考虑溶剂效应。你看,AI再聪明也还是缺了点儿物理直觉。他们只能回头改造模型架构,加入显式的溶剂化层,然后又花了一个月重新训练。直到某天晚上,那根期待已久的峰终于在色谱图上冒出来,大家才长出一口气。老赵说:“那一刻我才明白,失败不是成功之母,失败后的复盘才是。单纯失败,那就是失败他妈——老失败。” 行吧,这比喻挺糙的,但理不糙。
数据会说谎,但患者不会
去年底,他们把一个针对罕见病的新分子推进了临床前研究。这个病特别冷门,全球患者不到两万人,没有药企愿意投入,因为商业回报太低了。但团队里有个女博士,她表弟就是这种病,所以她拼了命地优化那个分子,几乎把每个参数都调到了极致。有一次她发现模型给出的关键中间体合成路线有六步,成本太高,可能患者根本用不起。于是她又一头扎进逆合成分析模块,硬是改出一条三步法的路线,成本压了70%。“数据会说谎,但患者不会。”她这句话后来成了团队的非正式格言。AI能给你漂亮的IC50值、完美的ADMET属性,可如果最后药价高得离谱、或者根本没法量产,那些数据就是一堆彩色泡沫。现在他们每做一个项目,都会专门考虑可及性指标,这玩意儿在AI模型里原本是没有的,是他们一点一点用真实世界的数据“教会”模型的。有时候我觉得,这才是创新最动人的地方——不是算法多炫酷,而是它真的能落到地上,砸出一个坑。
这行业,卷得有点意思
今年行业里动静不小。英伟达的Clara for Drug Discovery持续升级,谷歌DeepMind的AlphaFold3也出来了,把药物设计效率又抬上一个台阶。有人担心,巨头入场,小团队还有活路吗?深维智药的人倒挺淡定。“他做他的通用平台,我啃我的特定疾病。就像都叫厨师,有人做满汉全席,有人专精一道麻婆豆腐——把豆腐做到米其林级别,照样能活。”老赵这么一说,大家又乐了。不过他们也确实在找差异化的路。比如最近他们开源了一个针对中枢神经系统疾病的小分子库,里面全是能穿透血脑屏障的候选化合物,这玩意儿可是制药界的老大难。开源那天,社区里炸了,GitHub的fork数一晚上过千。有人留言问:“你们不怕被抄吗?”他们回:“怕啥,我们迭代比你抄的速度快。” 这种自信,还真不是吹的。
创新团队在实验室操作高通量筛选设备
前两天我去他们新搬的办公室,地方不大,但乱得很温馨。白板上全是画得歪歪扭扭的化学结构,角落里还堆着几箱红牛和泡面。小王给我展示他们最新的模型页面,得意地指着一个飙升的指标说:“看,这是我们上次那个失败项目的副产品,没想到在这儿用上了。” 失败项目都能变废为宝,这种团队,你让我怎么不信他们能成事儿?
说实话,写了这么多,我也想不出个漂亮的结尾。可能创新团队的风采本来就没什么固定模板,它就是一群不服输的人,在乱糟糟的真实世界里,一点点把不可能变成可能。对吧,有空你去他们实验室看看,那些亮到深夜的灯,比什么鸡汤都管用。