科研团队协作技术:那些年我们踩过的坑和神操作
团队协作技术到底有什么用?说实话,我刚进实验室那会儿觉得这玩意儿就是老板拿来唬人的。什么看板、什么晨会,纯属浪费时间。但后来——哎,真香。
去年我们组接了个大活,跟隔壁材料所联合搞光催化。跨学科,三个人在三个城市。你猜怎么着?项目启动第一周,我们就差点翻车。邮件来来去去几十封,Slack上消息闪个不停,最后发现催化剂配方传错了版本。版本控制,这词儿听起来像程序员的黑话,但那会儿才明白:没有Git,没有云协作文档,科研协作就是个泥潭。
 科研团队用GitLab管理实验数据版本
不是说笑。我专门去扒了哈佛大学Wyss研究所的一篇论文——他们用实时协同编辑,把基因编辑的载体设计效率提升了40%。听起来很神?其实原理简单:Google Docs那种同步,加上Slack的机器人提醒,每个人改一个碱基对,系统自动检查冲突。这要是搁我们组,还不得为谁动了质粒图谱打一架。
工具选得对,少加三天班
说到这里,我忍不住要吐槽某些“协作神器”。Teams?开个会卡成PPT。飞书?花里胡哨的功能一堆,真正用的就那几个。不过话说回来,Jupyter Notebook的协同功能——对,就是那个可以多人同时写代码、跑数据的玩意儿——简直拯救了我的周末。以前数据出了错,得拷屏、圈圈画画、发邮件,现在云端直接一改,所有人都看到,协同调试不是梦。
但工具是死的,人是活的。对吧?我见过最离谱的事:一个团队买了全套Atlassian全家桶,结果还是靠Excel表传数据。为啥?因为没人愿意学。所以协作技术的关键,不是技术,是共识。你得让每个人都觉得:嘿,这玩意儿真能省事儿。
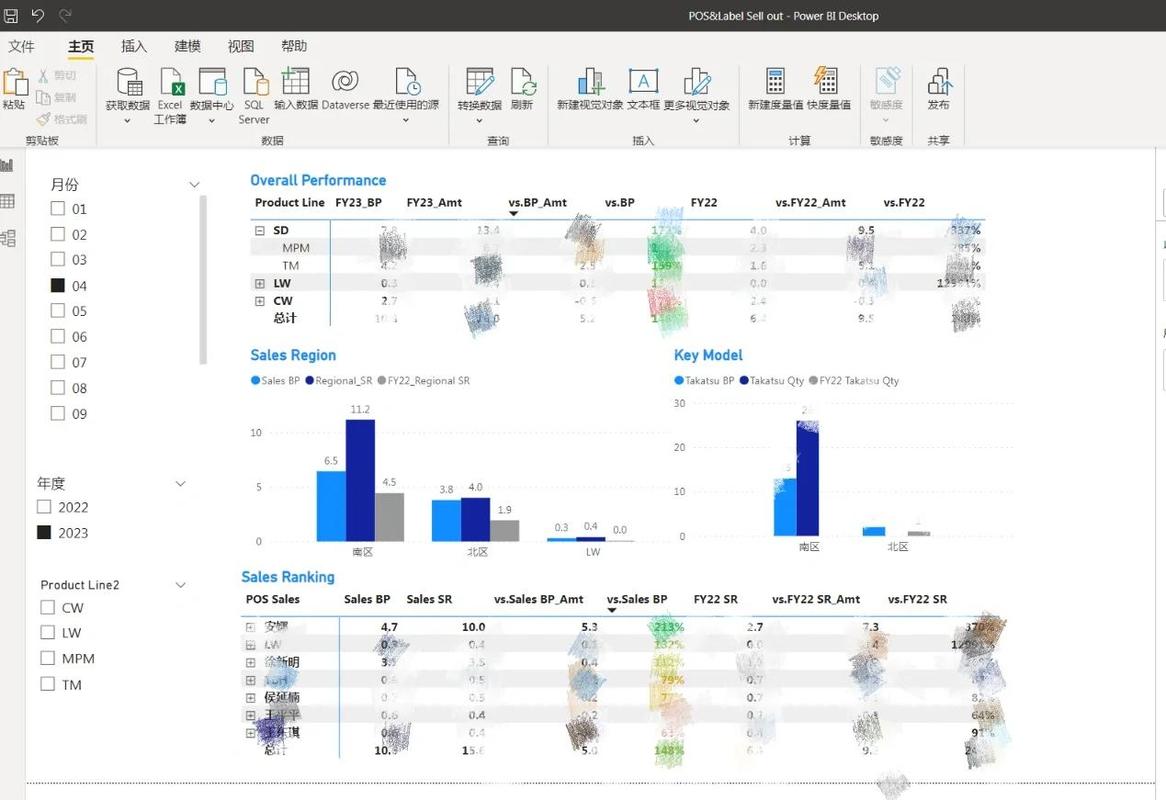 多人协同编辑Jupyter Notebook实时数据分析
沟通,沟通,还是沟通——但别只会开会
斯坦福有个研究挺有意思。他们分析了上千个科研项目的沟通模式,发现异步沟通远胜于同步会议。什么概念?就是别动不动就拉个Zoom,一开一小时。发条Loom视频,三分钟说清楚;Notion里留个评论,对方有空看。我们试过,简直不要太爽。尤其跨国合作,时差这东西,靠同步那就是互相折磨。
但异步也有坑。没人看怎么办?我们组的土办法:重要决策必须用可视化协作板,比如Miro。贴满五颜六色的便签,谁漏看了就在群里@,配上一个大哭表情。别说,还真管用。
数据透明化:敢不敢把原始记录亮出来?
这事关科研诚信。很多组藏着掖着,数据只有PI和具体做实验的人知道。结果呢?重复性灾难。MIT的开放科学运动搞了个电子实验记录本(ELN),要求所有数据实时共享。一开始阻力巨大——谁愿意让别人看到自己的失败数据?但坚持半年后,他们发现错误发现速度提高了一倍,文章接收率反而上去了。为啥?因为审稿人看到原始数据,信任度蹭蹭涨。
我们组最近也在学。Labstep或者Benchling这种工具,记录每个操作步骤,带时间戳,改不了。上次合作方问某个数据是不是P的,直接甩个链接过去:自己看历史记录。硬气!
 科研团队使用电子实验记录本Labstep记录实验流程
代码与数据的协作:fork, pull, merge, 别慌
如果你是做计算的,这节就是给你的。Git已经不是新鲜玩意儿了,但科研圈用好的真不多。好多人就是“commit onto master”然后祈祷不出事。正确的操作是分支策略:每个实验一个分支,合并前必须code review——对,找同事帮你逐行看代码。听起来变态?但十有八九能找到隐秘的bug。上次我写了个模拟退火的脚本,自认为完美,结果被师弟揪出一个参数边界错误。丢脸归丢脸,但文章保住了。
数据版本控制呢?DVC(Data Version Control)这工具,像给数据集上了个Git。没它之前,我们文件夹名字都是“data_final_v2_revised_真正最终版”。现在一个dvc push,整个世界清净了。
跨学科协作的翻译问题
生物学家和计算机科学家说话简直像两个物种。前者说“细胞通路”,后者以为是什么网络协议。这时候领域本体和统一数据模型就成了救命稻草。我们搞过一个“术语表”,贴在协作空间首页,每次开会前五分钟过一遍。别笑,就这五分钟省了几十个小时的误解。还有那种画图沟通法——白板上一通乱画,然后拍照传到Figma里标注——有时候比论文还清楚。
说到底,团队协作技术背后是人性。怕麻烦、想偷懒、又怕丢面子。你看那些成功的协作案例,往往不是因为用了什么高深工具,而是每个人觉得“这样干,我轻松”。要是能让你早点发CNS,你学不学?
反正我学了。