科研成果正在“洗劫”数字内容创作?别急,好戏才刚开始
上周三晚上,我盯着屏幕上一个由算法生成的3D模型发呆。那纹理,那光影...说实话,它比我们团队实习生手调的还要逼真。于是我开始想,我们这些自诩“内容创作者”的人,是不是快被干掉了?
别误会,我可不是在贩卖焦虑——我只是一个在数字创意行当里混了十年的老鸟,最近被一堆学术论文搞得心神不宁。那些实验室里的古怪名字,什么扩散模型、神经辐射场、大语言模型,正以前所未有的速度冲出论文预印本,直接砸到我们创作者的工具箱里。关键问题是,我们接住了吗?或者说,我们被砸晕了吗?
从“炼丹炉”到“一键生成”,我们失去了什么?
去年这时候,我还在给客户手绘概念图,熬夜调色阶。现在呢?打开Midjourney,输入几个词,回车。十秒,四张。爽吗?挺爽。怕吗?真怕。这就像给你一架F1赛车,但你连驾照都是买的。速度上去了,掌控感却没了。Stable Diffusion、DALL-E这些玩意儿,底层全是顶会论文的成果——CVPR、NeurIPS里的数学公式,转个眼就变成了滑块和按钮。科研转化之快,让人来不及消化。
 使用Stable Diffusion生成数字插画的工作流程对比
我有个朋友,资深原画师,去年还在骂AI是玩具,今年却偷偷用AI出草稿,再手动精修。他说这叫“半自动化尊严”。唉,听得我鼻子一酸。这还不算完,视频生成也杀过来了。Runway的Gen-2、Pika,输入文字就能生成动态镜头,虽然现在还像磕了药似的抽搐,但以论文迭代的速度,明年这时候呢?我们搞影视后期的,是不是也要学起“提示词工程”?最要命的是,内容越来越像。刷开任何一个设计平台,满眼的厚涂风、赛博朋克、宫崎骏变体,甜得发腻。算法在喂养我们的审美,还是我们在给算法打工?
神经渲染:当虚拟吃掉现实
再说个让我起鸡皮疙瘩的技术:神经辐射场,简称NeRF。你拿手机围着物体拍一圈,它就能重建出可任意旋转的高精度3D模型。去年英伟达的Instant NeRF发布,我第一时间试了手。导入自己拍的咖啡杯,几分钟后,一个近乎完美的三维杯子就在屏幕上旋转。那一刻,我后背发凉——我们花十年学会的布线拓扑、UV展开,现在一个APP就搞定了?这还没提那些更变态的,比如直接从单张图片生成3D场景,或者实时渲染出电影级光影。Luma AI的小程序已经能让普通用户扫描房间,导出给引擎用。
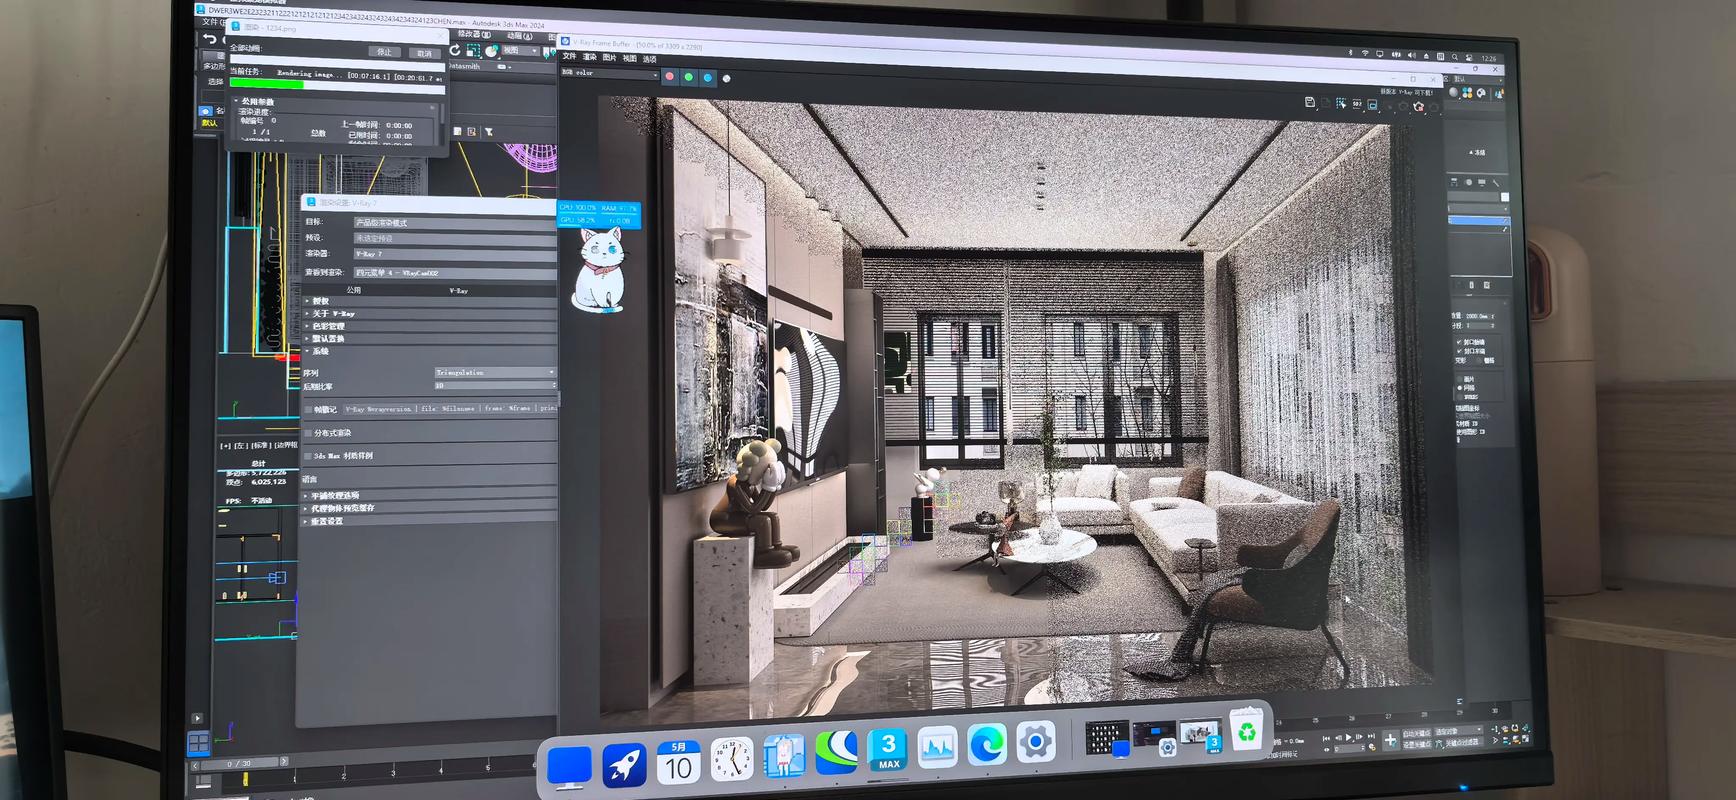 手机应用扫描真实房间生成3D模型的场景
影视行业更魔幻。《曼达洛人》用LED虚拟制片替换绿幕,背后是实时渲染和跟踪的科研成果。现在,神经渲染直接把这一套带到家用电脑上。我最近参与的一个小项目,导演心血来潮想加个异星废墟镜头,按老流程得建模、贴图、打光、渲染,至少三天。结果我用一个基于NeRF的工具,导入了几张实拍废墟照片,两小时后,一个能互动的3D场景就丢进了引擎。导演兴奋得拍大腿,我却心里不是滋味——以后这类活儿,是不是更不值钱了?
版权泥潭:谁在喂养AI,谁就被它反噬?
 版权泥潭:谁在喂养AI,谁就被它反噬?
搞创作的人,现在多少都有点PTSD。去年Getty Images告Stability AI,说它用版权图训练模型,国内也冒出好几起“AI画出的东西和我原创撞车”的纠纷。学术圈更是个大黑洞,论文里用的大规模数据集,有几成是真正清白的?说实话,我们这些一线创作者,就像在雷区跳舞。一边贪婪地用AI提效,一边提防哪天自己的作品成了训练样本,反过来取代自己。有次我在一个分享会上吐槽,说这简直是在给一个巨大的公关危机写剧本,而主演就是我们。台下一片苦笑。
现在有些科研团队开始搞“抗AI”技术,比如给图片加肉眼看不见的扰动,破坏模型训练。可这终究是创可贴。法律跟不上,伦理在裸奔,技术却光速狂飙——我们夹在中间,时而狂喜,时而崩溃。
虚拟人的“演技”进化,谁还分得清真假?
 虚拟人的“演技”进化,谁还分得清真假?
去年参加一个行业闭门会,看到一段演示:一个完全由AI驱动的虚拟主播,实时回答观众提问,表情、口型、手势,滴水不漏。背后是扩散模型加语音驱动动画的最新研究成果。科大讯飞、小冰、甚至NVIDIA Omniverse,都在往这个方向猛砸。你猜我当时什么感觉?不是惊艳,是恍惚。想想看,再过两年,直播间里跟你卖口红的,可能根本没有实体。偶像、客服、甚至新闻播报——全都可以用一串代码代替。更魔幻的是,现在用手机拍段视频,就能快速克隆出一个自己的数字分身,动作、声音都像。我一个做MCN的朋友已经开始用这个技术批量生产视频了,他说:“没办法,真人成本太高。” 好嘛,搞内容创作的,自己先要被内容替代了?
夜里我关掉那个逼真的模型,打开手绘板画了两笔。线条抖得厉害,但心里踏实了些。也许,工具再先进,创作的快感还是得靠手感。对吧?至少,现在还是。