从模型能力到现场约束:人工智能产业应用落地缝隙观察
先把结论放一边。一个视觉模型在展台上识别样本很准,搬进车间后,灯光角度、工件反光、传送带节拍、遮挡关系一变,准确率就掉下来。这很常见。问题不在模型“不聪明”,而在产业场景从来不是静态测试集。模型面对的是分布偏移、长尾样本和实时约束叠加后的系统问题。
 智能制造车间机器视觉质检工位示意
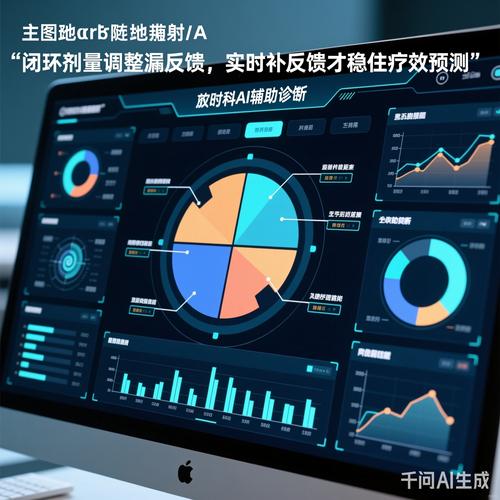 医院影像科AI辅助诊断工作流界面
 上线之后,组织要替误差留出通道
模型上线只是起点。真正难的是组织流程改造。谁对误判负责?模型输出进入工单系统后,人工还能不能推翻?审计日志是否保留输入、版本、阈值和复核意见?这些问题不解决,系统自动化程度提高,风险却集中。高风险场景如辅助诊断、信贷风控、自动驾驶,通常需要冗余设计、可回退机制和外部认证;低风险场景如内部知识检索、营销素材初筛,可以快速试错。边界不同,治理强度就不同。
实现路径上,影子模式和灰度发布稳妥,“一次性替换”风险集中。先让模型在旁路运行,与人工结果比对,积累误差分布;再小流量上线,设置漂移监控和回滚阈值。指标也要改:不能只看准确率,还要看漏检成本、复核负担、响应时延和故障恢复时间。采购模式同样关键。按项目验收的一次性交付,容易留下“模型交付即老化”的问题;持续运营合同才能覆盖数据漂移和版本迭代。这里有个反例:客服机器人上线后回答准确率看似不错,但遇到合规话术变更时没有知识更新流程,错误回答被放大。问题不在语言模型,而在知识治理缺位。
展台精度与产线节拍不是一回事
机器学习擅长在给定分布内找统计规律。产业现场却不断改变分布:换批次、换模具、换班次、换供应商,甚至连相机镜头的灰尘都会改变输入。实验室里讨论平均精度,产线上关心漏检一次要付出多少成本。两者不是同一个目标函数。一个缺陷检测系统若把漏检率压到很低,往往要牺牲吞吐或增加人工复核;若一味追求节拍,边缘推理的算力预算又会被卡住。这里没有免费午餐。 所以讨论人工智能产业应用,不能只看模型指标。要把它放回“数据—推理—决策—反馈”闭环里看。边缘端负责低时延推理,云端负责训练和版本管理,规则引擎处理确定性约束,人工复核吸收不确定性。哪一环缺失,系统都会在规模复制时暴露。反例并不少:某些OCR票据识别在单张测试集上表现很好,接入财务流程后,因为票种长尾、盖章遮挡和版式更新,错误率上升,结果不得不加回人工录入。不是技术无效,而是边界没被写清楚。智能制造车间机器视觉质检工位示意
数据闭环常被误读为“多采多标”
数据重要,但“数据越多越好”是个粗糙判断。产业数据的价值取决于标注一致性、采样覆盖和与决策目标的对齐。医疗影像里,不同医院的重建参数和扫描协议会改变图像分布;工业质检里,缺陷定义本身可能因工艺标准变化而漂移。此时堆数据,可能只是把旧偏差采得厚。麻烦的是,标注者之间不一致。一个“轻微划痕”到底算不算缺陷,如果没有工艺工程师参与定义,标注集就会变成噪声源。 我倾向于把数据看作工艺参数的一部分,而不是通用燃料。它需要版本、来源、采集条件、标注规范和变更记录。合成数据可以补长尾,但有条件:仿真分布必须覆盖真实扰动,否则只是把模型训练成适应仿真器。隐私合规也限制跨机构聚合,联邦学习、差分隐私、可信执行环境各有代价,不是贴上标签就能解决。小样本高价值场景里,迁移学习和领域自适应在盲目标注之外提供务实路径。说实话,数据飞轮不是自动转的,它需要人维护轴承。医院影像科AI辅助诊断工作流界面
上线之后,组织要替误差留出通道
上线之后,组织要替误差留出通道
模型上线只是起点。真正难的是组织流程改造。谁对误判负责?模型输出进入工单系统后,人工还能不能推翻?审计日志是否保留输入、版本、阈值和复核意见?这些问题不解决,系统自动化程度提高,风险却集中。高风险场景如辅助诊断、信贷风控、自动驾驶,通常需要冗余设计、可回退机制和外部认证;低风险场景如内部知识检索、营销素材初筛,可以快速试错。边界不同,治理强度就不同。
实现路径上,影子模式和灰度发布稳妥,“一次性替换”风险集中。先让模型在旁路运行,与人工结果比对,积累误差分布;再小流量上线,设置漂移监控和回滚阈值。指标也要改:不能只看准确率,还要看漏检成本、复核负担、响应时延和故障恢复时间。采购模式同样关键。按项目验收的一次性交付,容易留下“模型交付即老化”的问题;持续运营合同才能覆盖数据漂移和版本迭代。这里有个反例:客服机器人上线后回答准确率看似不错,但遇到合规话术变更时没有知识更新流程,错误回答被放大。问题不在语言模型,而在知识治理缺位。