技术组合优化:为什么单独跑通的技术拼到一起就崩了
上周在南京软件大道的产业园会议室,空调开得太足,对面做光伏板外观质检的CTO把笔记本往桌上一摔,说他们踩坑踩得快吐了。
之前单测的时候,缺陷识别模型在公开数据集上跑mAP能到92%,边缘端的推理加速模块单独测延迟能压到80ms以内,结果俩东西拼到产线的实际工位上,模型推理时不时卡成PPT,漏检率直接飙到17%。
说出来你可能不信,这个团队之前为了选最合适的模型,光在公开数据集上跑对比就花了快两周,结果到现场一周就崩了。真的,我当时听着都替他们累。
单技术的最优解,往往是组合里的最差解
很多团队做技术选型的时候,是按单点指标卡的——选计算机视觉模型,就看公开数据集上的精度测试值,选边缘推理框架,就看官方benchmark里的吞吐数据,根本没算过两个技术栈叠在一起的时候,内存峰值抢占冲突。
没人提前算过。
比如刚才那个质检团队的问题,他们用的YOLOv8的量化版本,本身对内存的峰值占用是1.2G,选的推理框架为了抠延迟,把内存预分配阈值设得特别低,俩东西凑一起,一旦产线的光照突然变了,模型要拉取缓存里的图像增强模块参数,直接就触发内存溢出保护,推理进程直接被系统杀掉。之前在实验室里测的时候,环境光照是恒定的,根本碰不到这种极端场景,所有的单点测试结果都完美得挑不出错。
类似的坑我见过太多了。有个做智能仓储的团队,把自动导航的激光雷达定位算法、路径规划模块、货箱抓取的视觉算法,三个单独测都没问题,拼到一起的时候才发现,激光雷达的扫描频率是20Hz,路径规划的计算周期是100ms,视觉抓取的推理是每帧120ms,三个任务在同一台边缘工控机上跑,CPU的上下文切换开销直接占了总算力的40%,最后导航的实际响应延迟从设计的200ms涨到了700ms,遇到突然窜出来的分拣员根本刹不住。
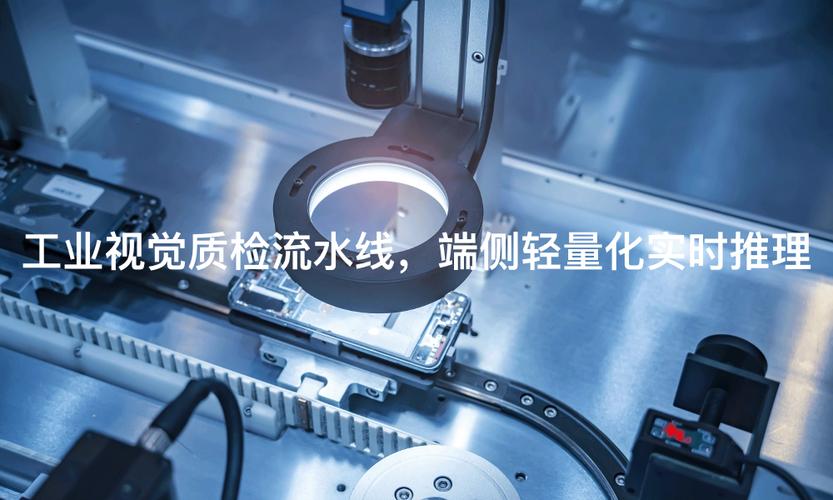 工业质检产线边缘端推理设备部署实拍
这里的核心矛盾根本不是技术不够好,是大家默认“每个模块单独跑通=整体能跑通”。技术组合里的损耗,从来不是1+1=2的线性叠加,是有深层耦合冲突的——不同技术模块对算力资源的抢占优先级不匹配,对输入数据的格式要求不兼容,甚至是不同技术的版本依赖踩了同一个底层库的坑。之前碰到过一个做内容推荐的团队,把用户行为埋点模块和大语言模型的用户画像生成模块拼到一起,埋点模块用的是1.18版本的protobuf,模型推理服务用的是23版本的,光数据序列化的格式不兼容,就卡了整整一周,俩模块单独跑的时候都完美得不行。
组合的边界,从来不是技术能力的天花板
不少人有个误区,觉得只要把能想到的技术都堆上去,效果肯定更好。根本不是。
就拿那个光伏质检的团队来说,一开始想的是把超分辨率模块、缺陷分类模型、异常光照补偿算法、边缘加速框架四个东西全堆上去,觉得精度能做到99%,结果算下来,四个模块的总内存需求是4.7G,而现场的边缘工控机因为要跟MES系统对接,能留给推理任务的内存只有3.2G,硬塞的话就得把系统的其他对接进程杀掉,生产数据传不回去,反而出更大的问题。
实际的落地边界从来都不是由技术能力决定的,是三个硬约束框死的。第一是硬件的资源天花板,不是你想上多少技术就能上多少;第二是业务流程的容忍度,比如产线的节拍是每2秒过一块光伏板,你组合的技术总推理时间超过2秒,再好的精度也没用;第三是运维的复杂度,你组合的技术栈里有三个不同团队开发的模块,每个模块的日志格式都不一样,出问题的时候运维找半天找不到根因,最后整个系统的可用率从99.9%掉到92%,谁都担不起这个责任。
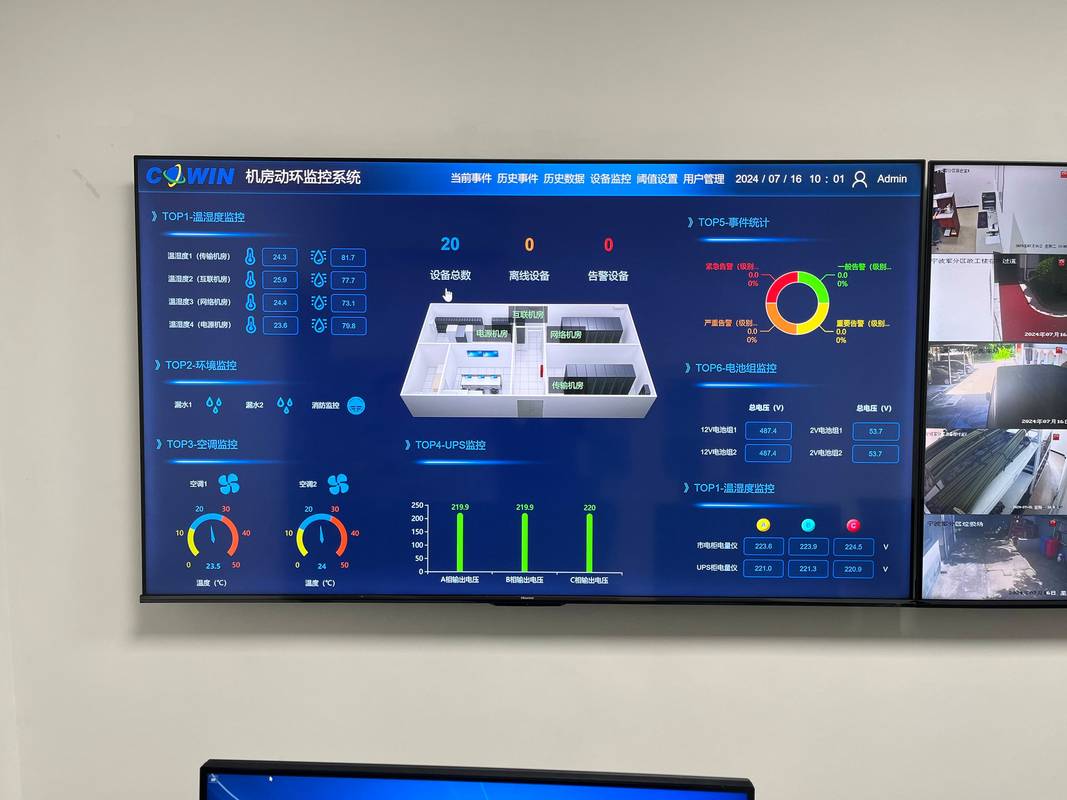 光伏板外观质检工位的工控机运行参数界面
还有个很容易踩的坑:为了追求技术栈的“先进度”,硬把不需要的技术组合进去。前两年大模型火的时候,有个做社区团购的履约团队,本来用的简单的路径规划算法,能把配送员的路线规划时间压到3秒以内,结果看到别人都在接大模型,硬把大语言模型嵌进去,让模型自动生成配送员的上门提醒话术,还要动态调整路线,最后整个系统的响应时间从3秒涨到了12秒,遇到早高峰的订单峰值,系统直接卡崩,配送员在APP上刷不出路线,当天的履约超时率涨了8个点。
你说这是技术不好吗?不是,是根本没搞清楚这个场景下,组合这些技术的收益能不能覆盖掉带来的成本。有的团队做组合的时候,根本不算账——比如每加一个技术模块,带来的精度提升是0.5%,但是带来的算力成本上涨是20%,运维复杂度上涨30%,这种组合根本就没有落地的价值。
踩过坑之后摸出来的落地逻辑
真的,哪有那么多神话啊。
那个踩坑的光伏质检团队,后来调整了整个技术模块的部署位置,把超分辨率模块从边缘端移到了云端,边缘端只跑最核心的缺陷检测和光照补偿,内存占用直接压到了1.8G,推理延迟稳定在75ms,漏检率直接降到了2%,根本不需要把所有东西都塞到一个盒子里。他们后来总结的第一条经验,就是前置耦合度测试——别一开始就想着把所有技术都拼上去,先把选好的几个技术模块,放到同一个模拟的硬件环境里跑一周,看看内存峰值、CPU占用、延迟波动这些硬指标,别等部署到现场了才发现俩模块抢资源。
那个智能仓储的团队,后来的调整思路也很简单:给每个技术模块设明确的资源分配优先级。激光雷达定位是最高优先级,占40%的CPU资源;路径规划是次高优先级,占35%;视觉抓取是最低优先级,占20%,剩下5%的资源留作系统上下文切换的缓冲,最后整个系统的响应延迟稳定在220ms,上下文切换的开销直接降到了总算力的8%。之前他们总想着给每个模块分固定的资源,结果遇到异常输入的时候,某个模块占满了所有资源,其他模块直接卡死,设了优先级之后,哪怕视觉抓取模块出问题,也不会影响导航的核心功能,不会出安全事故。
还有个容易被忽略的点:别追求技术栈的“绝对统一”。很多团队觉得全栈用同一个厂商的技术,兼容性肯定好,结果碰到业务需求变了,想换其中一个模块,发现整个技术栈全被锁死了,换都换不了。之前有个做在线教育的团队,从直播模块、互动白板到作业批改的大模型,全用的同一个云厂商的技术,本来以为兼容性拉满,结果去年那个云厂商的大模型涨价30%,想换别家的模型,发现跟互动白板的接口全是定制化的,换一次要改三个月的代码,最后硬生生多掏了几十万的成本。好的组合从来不是把所有模块都焊死在一起,是每个模块之间留好标准解耦接口,哪怕其中一个模块要换,也不会牵一发动全身。
上周从南京回来的高铁上,我翻了之前攒的半本踩坑笔记,发现之前大家聊技术的时候,总觉得技术越新、堆得越多,系统就越厉害。真到了落地的场景里,根本不是那么回事。你花几十万买的最先进的模型,拼到现场的老旧工控机上,可能还不如一个简单的轻量化模型跑的稳。你跟同行吹的天花乱坠的技术栈,到了生产环境里,可能因为一个小小的版本依赖冲突,卡你半个月。
对吧。