基因编辑脱靶检测:我们还没摸透CRISPR剪刀的刃口
去年深秋在南京紫金山下的实验室,我见过刚跑完三代测序的凝胶图——条带歪歪扭扭,本该亮在靶位点的带型旁边,多了两团模糊的影子。那是我们做了三个月的小鼠胚胎编辑样本。本来预期的单碱基替换,偏偏在非目标区段切了两刀。没人敢直接往下做移植。
那些被漏掉的剪切点,从来不是小问题
早期做基因编辑的人,大多都有过类似的经历。一开始我们总觉得,脱靶就是剪刀找了和靶序列长得像的地方下了手——毕竟Cas酶识别靶序列靠的是碱基互补配对,差几个匹配不上,总该不会切吧?
这个想法骗了我们好多年。
传统的同源序列预测模型,最多能覆盖不到30%的实际剪切位点。2015年前后整个领域都在靠计算机列潜在脱靶位点,然后挨个扩增测序,结果有课题组对着小鼠全基因组做无偏好检测的时候才发现,超过七成的实际剪切位点,和靶序列的同源性低到连预测软件的阈值都够不上。
说起来好笑,我们前两年还信过某款商业软件的预测报告,拿着它列的12个潜在位点挨个测,测完发现样本里有三个剪切点根本不在列表里。当时整个实验室的人对着测序数据愣了半小时——这相当于你拿个筛子捞鱼,捞了半天发现筛子眼全在水外面。
这些漏掉的位点从来不是无关紧要的噪音。2021年有个临床I期的基因编辑项目,本来用在造血干细胞上的gRNA,被发现会在一个抑癌基因的内含子区域产生低频率的剪切,直接导致整个项目暂停了六个月。你永远不知道那个藏在非编码区的剪切点,会不会刚好碰掉一个调控元件,会不会在几年后诱导出癌变。
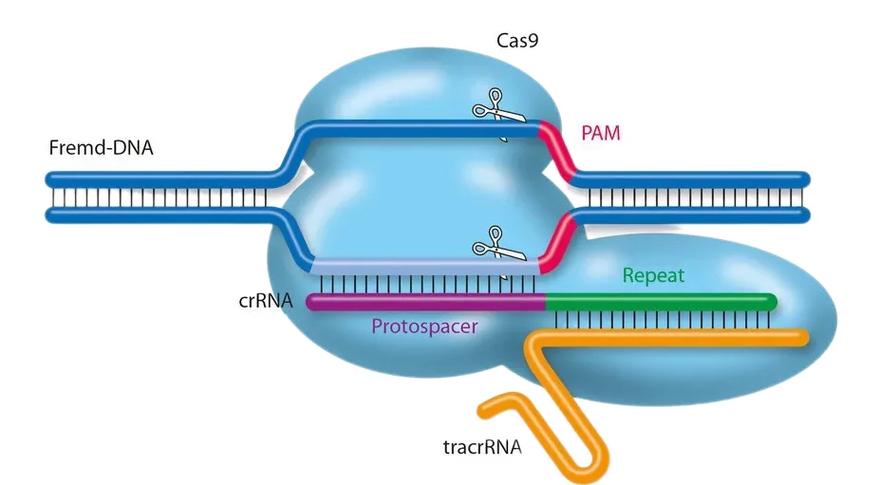 CRISPR-Cas9非同源剪切位点分布示意图
从“找相似”到“抓现行”,方法绕了十年弯路
意识到预测模型靠不住之后,整个领域花了差不多五年时间,把检测思路从“按图索骥”改成了“无偏好抓现行”。
最早出来的GUIDE-seq算是个转折点。它靠把一种短的双链寡核苷酸转进细胞,只要基因组里出现了双链断裂,这个寡核苷酸就会插进去,最后把所有插了标记的位点捞出来测序——等于给所有剪切点装了个摄像头。
但这个方法也有致命的毛病。
寡核苷酸要转进细胞本身就是个门槛。对于细胞系样本还好,转染效率能到70%以上,测出来的结果基本靠谱。要是换成体内直接编辑的组织,比如小鼠的肝脏、大脑,寡核苷酸根本递不进去,摄像头等于白装。我们去年用GUIDE-seq测细胞系样本,同一种gRNA找出来17个剪切位点,换成体内注射的小鼠肝脏样本,只找到了4个。一开始还以为是体内编辑效率低,后来才发现是肝细胞的转染效率不到5%——大半的剪切点根本没被标记上。
后来又出来了CIRCLE-seq、Digenome-seq这些体外检测方法,把基因组提出来打断,在试管里加Cas酶和gRNA,看哪些片段被切了。但体外的基因组是裸露的,和体内折叠成染色质的状态完全不一样,很多位点在体内被组蛋白挡住,根本碰不到,体外测出来的脱靶谱,到了体内直接打对折。
现在大家普遍更倾向于用全基因组深度测序做验证。基于全基因组测序的无偏好检测,现在已经能做到单碱基分辨率下的结构变异识别,不需要任何标记,不管是细胞样本还是组织样本,只要提了基因组就能测。
但贵。
我们上个月测一个临床前的样本,30X的全基因组测序跑出来什么脱靶都没发现,后来加到200X的深度,才在一个内含子区域找到了一个频率只有1.2%的剪切位点。那一笔测序费,够买三个月的分子生物学试剂。
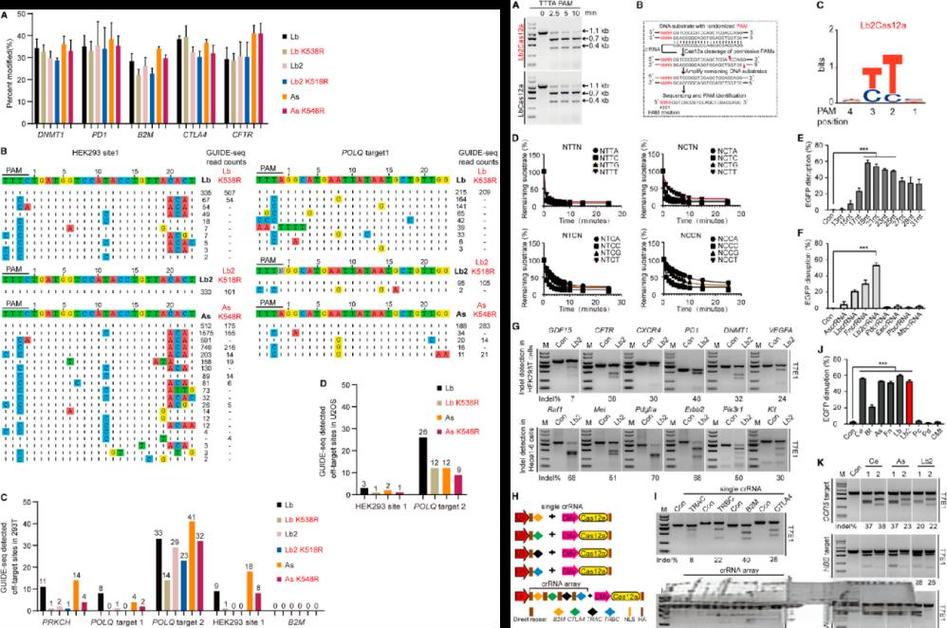 不同基因编辑脱靶检测方法的适用场景对比图
我们现在能测出所有脱靶吗?显然不能
很多人觉得现在技术成熟了,只要测够深的测序,就能把所有脱靶都找出来。真不是。
最早的Cas9介导的双链断裂脱靶,现在的方法基本能覆盖个七七八八。但这两年火起来的单碱基编辑、Prime编辑,根本不产生双链断裂,之前的那些找双链断裂的方法,全没用。
比如胞嘧啶单碱基编辑器CBE,之前有研究发现它会在RNA水平产生大量的随机脱氨基突变,还有的会在基因组里产生低频率的单碱基替换,这些变化不会形成双链断裂,之前的检测方法根本抓不到。你要是只测DNA的双链断裂位点,等于只查了小偷撬锁的痕迹,人家翻窗户进来你根本没看见。
更麻烦的是,脱靶的风险从来不是静态的。gRNA的序列、Cas酶的浓度、编辑的组织类型、甚至个体的基因组差异,都会改变最终的脱靶谱。
我们之前和医院合作过一个T细胞编辑的临床前项目,用同一个gRNA在三个健康供体的T细胞里做编辑,最后测出来的脱靶位点重合率不到40%。其中一个供体的基因组里刚好有个SNP,和gRNA的部分序列刚好互补,凭空多出来一个之前从来没见过的剪切位点。当时整个项目组都傻了——这意味着你在实验室用细胞系测出来的脱靶谱,到了不同病人身上,完全可能是另一套。
现在FDA对于基因编辑的临床前申报,已经要求必须用至少两种无偏好的脱靶检测方法,不能只靠计算机预测。但到底要测到什么深度才算够?测到的脱靶位点在非编码区,到底要不要紧?如果那个位点刚好是个还没被注释的增强子,会不会导致长期的基因表达异常?这些问题现在都没有标准答案。
说实在的,我现在每次拿到新的脱靶检测报告,都不会像前几年那样直接松口气。总觉得还有什么东西藏在数据后面——毕竟我们现在能看到的,只是剪刀切出来的明面上的口子,那些没被切开的、只是稍微碰了一下的位点,会不会在几个月甚至几年之后出问题?没人知道。
上个月去上海开学术会,听一个老师讲他们新开发的高保真Cas变体,脱靶率比野生型低了两个数量级。我当时在底下记笔记,突然想起三年前在南京实验室对着凝胶图愣神的那个下午。
其实路还长。
但至少我们现在知道,要找的不是那几个看得见的条带,是整个基因组里所有可能被碰到的地方。