硅光芯片与光互连:被功耗墙逼出来的算力新路线
上周跟做服务器硬件的老陈吃烤串,他攥着烤筋骂了二十分钟——现在单颗GPU功耗奔着700W去,铜互连的散热和传输损耗快把整机柜的设计逼疯了。
真的,不是厂商偷工减料。
之前为了把800G的链路从GPU连到交换芯片,老陈的团队前后改了七版PCB走线,阻抗调了又调,最后跑满速率的时候,整条铜链路的温升比芯片本身还高。散热成本涨了三成,传输距离还缩到了不到半米——再往上走,1.6T、3.2T的速率,铜缆根本扛不住。
铜互连的死局,真的不是厂商偷工减料
很多人对高速互连的认知还停留在十年前,觉得铜线缆便宜、可靠,为什么非要折腾光。说白了,是物理定律卡脖子了。
现在800G以上的电互连链路,每传输1bit数据的能耗,已经是同速率光链路的3到4倍。更别说趋肤效应带来的信号衰减,频率越高,电流越往铜导线的表面跑,有效导电面积越来越小,传输损耗直线上升。还有躲不开的电磁干扰,之前老陈他们做的整机柜EMC测试,连续三轮不过,最后加了三层屏蔽罩,单柜成本多花了十几万,传输距离还比最初的设计短了20厘米。
搁以前,这点损耗根本不算事。但现在大模型训练的集群,动辄几万张GPU卡,卡和卡之间的互连带宽要求每年翻倍涨,铜互连的功耗已经占到了整个集群通信功耗的40%以上。相当于你花了一半的电,不是用来算模型,是用来给这些铜线的信号衰减补功率。
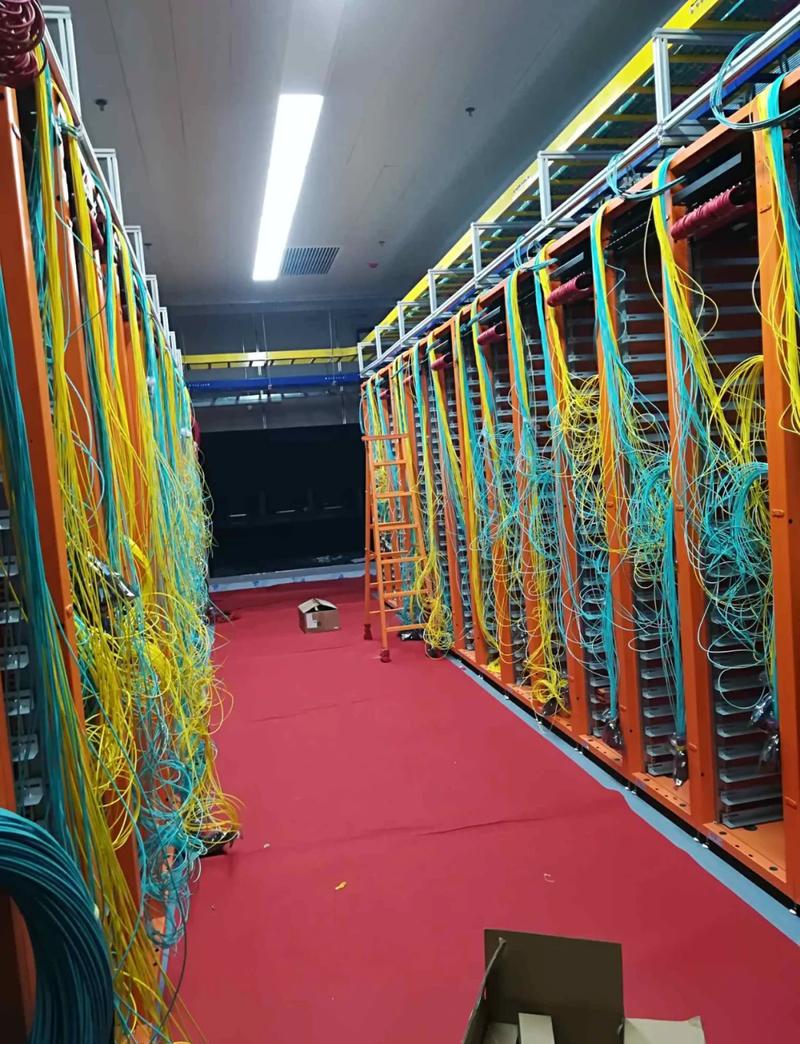 数据中心服务器机柜铜互连高速布线实拍图
说穿了,铜互连不是不好,是真的走到物理极限了。
光互连不是什么新东西,为什么现在突然火到挤破头
别听那些营销稿把硅光吹成什么颠覆时代的黑科技。光传输本身都用了几十年了,从最早的骨干网光纤,到城域网,再到后来的接入网,光的优势大家都知道:带宽大,损耗低,没有电磁干扰。但之前的光互连,全是用在长距离传输上,短距离的服务器内部、芯片之间,一直没人愿意换——成本太高,体积太大,可靠性也没经过验证。
为什么现在突然全行业都在挤着搞硅光?因为算力涨得太快了。
英伟达去年推的H100集群,单节点的互连带宽已经到了900GB/s,今年的H200、B100,直接把带宽拉到了1.8TB/s。原来的铜缆能传3米的800G信号,现在1.6T的速率下,传30厘米就衰减到没法用。总不能把所有GPU都堆到离交换芯片30厘米以内吧?那整机柜的布线密度得乱成什么样。
这时候硅光的优势就出来了。说白了,就是把原来光模块里的调制器、波导、探测器,全用CMOS工艺刻到硅片上,不用再像以前那样把各个分立的光学元件挨个拼起来。现在国内已经有团队做出了单波100G、共32通道的硅光光引擎,整体尺寸比原来的可插拔光模块小了60%,功耗还降了一半。
 100G单波硅光光引擎芯片显微镜实拍图
之前有个做传统光模块的朋友跟我吐槽,说前两年还在跟客户吹自己的可插拔模块良率做到99%,现在硅光的封装良率才刚到80%,整个产线要重新建,老设备全砸手里了——说多了都是泪。但不换又不行,客户的新集群明年就要上1.6T的链路,你拿不出硅光的方案,订单直接就被别人抢了。
我上个月去苏州的一家硅光创业公司参观,他们的工程师把刚做出来的光引擎接到测试台上,跑1.6T的速率,误码率压到1e-12的时候,整个实验室的人都在鼓掌。那种你熬了快两年的流片,最后真的能跑通的成就感,真的不是拿多少融资能比的。
现在的硅光光互连,离真的大规模落地还差哪几步
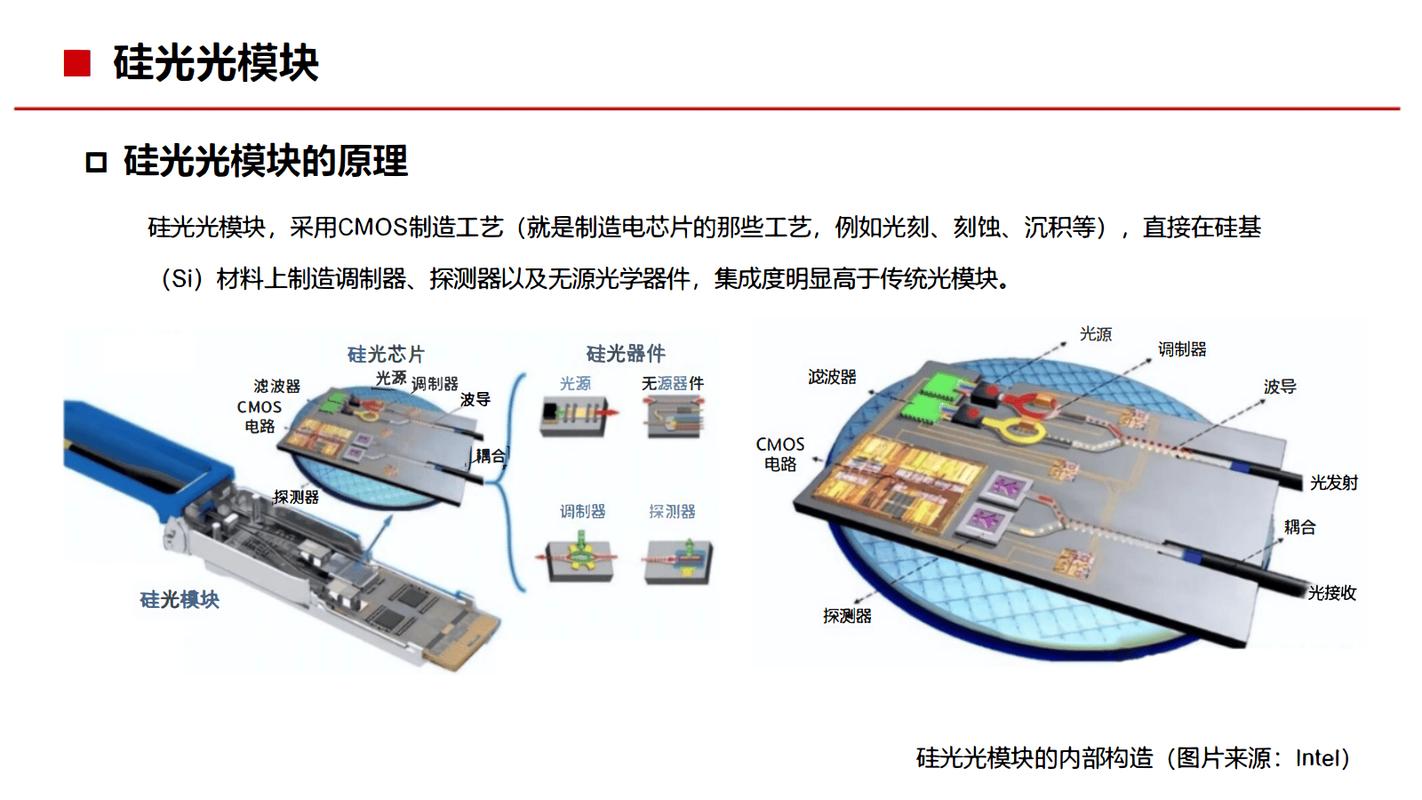 现在的硅光光互连,离真的大规模落地还差哪几步
真的没那么玄乎。现在吹硅光马上就要替代所有电互连的稿子,我看了都头疼。
首先是成本的坎。虽然硅光用的是通用CMOS产线,但是因为要做特殊的高折射率差波导层,MPW的流片费用比同尺寸的数字芯片贵3倍都不止。中小创业团队凑一次流片的钱,可能就要掏几千万,更别说后面的封装测试。之前有个团队跟我算过,现在做一块可量产的硅光光引擎,成本还是同速率电互连方案的2倍多,除非产能提上来,不然数据中心客户根本不会大规模换。
然后是耦合的难题。硅光芯片上的波导,宽度才0.5微米,普通单模光纤的芯径是9微米,要把光从光纤耦合到波导上,对准精度要到0.1微米——比头发丝的直径还细100倍。现在的主动耦合设备,一台就要几百万,良率稍微波动一下,成本就兜不住。更别说放到实际的机柜里,温度从10度飘到70度,振动也有,光对准的位置稍微偏个0.05微米,信号可能就断了。
还有那个老生常谈的激光器问题。硅本身是间接带隙材料,根本没法高效发光,现在所有的商用硅光芯片,都是把外置的III-V族激光器贴到硅片旁边,耦合损耗就占了整个链路损耗的40%。之前有团队测过,光是这个耦合环节的损耗,就让整个光引擎的接收灵敏度降了3dB,要多花一倍的激光器功率才能补回来。要是哪天能把激光器直接长到硅片上,成本至少能砍一半。
之前我看2024年ISSCC上斯坦福团队的论文,人家直接把光互连做到了处理器的封装里面,核间的光互连带宽做到了10Tb/s每平方毫米,功耗比原来的电互连低了一个数量级。当时我看完第一反应是,这要是真能量产,现在困扰整个行业的内存墙、缓存墙问题,说不定真能解决一半。但那毕竟是实验室的样品,离量产还有十万八千里。
有人说硅光会把所有的电互连都替代,我看未必。毕竟现在板级的短距离互连,比如芯片到PCB的几厘米连线,铜缆还是有绝对的成本优势。真到了机柜间、机架间的长距离高速传输,光互连的优势才会彻底显现出来。
上周老陈给我发消息,说他们公司已经开始跟国内的硅光团队谈合作了,明年的新服务器机型,就要把原来的长距离铜互连链路换成光互连的方案。
你看,技术的迭代从来都不是什么惊天动地的大事。
就是大家被功耗逼得没办法了,才会真的掏钱换路线。