别等服务器炸了才拍大腿:落地可用的灾备技术方案避坑指南
去年深秋的一个凌晨,我接到老陈的电话,他声音抖得像筛糠。
他们公司做在线文档的,租的机房被施工队挖断了主干光缆,整个服务瘫了。
整整12个小时。
最后算下来,光客户违约金就赔了230多万,还丢了快两成的付费用户。
他跟我吐槽,之前也想过做灾备,看了好几个方案,觉得太贵,想再等等。
等就等出事了。
扯什么呢。
先把两个核心指标搞懂:RTO(业务能扛住的最长中断时间),RPO(业务能接受的最大数据丢失量)。
比如你是做面向C端的生鲜电商,大促的时候系统挂10分钟,客户就要在评论区骂到关店,丢一笔订单数据都是实打实的营收损失,那RTO就得压到15分钟以内,RPO最好压到0。
但如果你是做内部用的考勤系统,就算挂个4小时,员工晚填个半天的打卡记录,也没人真的要跟你拼命,那RTO定个4小时,RPO允许丢1小时的数据,完全够用。
我见过最离谱的客户,给内部的打印机管理系统定的RTO是5分钟,RPO是0。
合着打印机晚启动5分钟,全公司人都要站在打印室等是吧?
纯纯的资源浪费。
 不同规模企业灾备等级匹配对比表
第一类,本地级别的备份方案。
说白了就是定时把数据库、用户文件打包,存在本地的NAS或者云厂商的冷存储里,成本极低。我认识的一个独立开发者,做的是小众的宠物交流社区,就靠每周自动打一次数据库快照,一个月花的存储费才37块钱。上个月服务器被黑,对方把所有用户数据全删了,他花了1小时40分钟就把数据全恢复了,损失连两百块的服务器租赁费都没到。
第二类,同城双活方案。
就是在同一个城市,找两个相隔30-50公里的机房,两边同时跑一样的业务,网络打通实时同步数据,一个机房出问题,流量直接切到另一个,用户甚至感觉不到中断。这东西的成本大概是本地备份的6-10倍,适合用户量过百万的中等SaaS公司。
但这里有个天大的坑。
很多供应商拍胸脯说我们的双活RPO是0,一点数据都不丢。
扯。
跨机房的网络哪怕只有1ms的延迟,只要同步的时候网络抖一下,就会有几十毫秒的数据差,真遇到极端的链路故障,丢个几百条数据太正常了。去年有个找我咨询的客户,之前花了80多万上的双活,上次机房电力故障切流量,最后丢了327条客户的合同签署记录,找供应商扯皮,人家翻出合同指给他看——上面写的是“RPO趋近于0”。
文字游戏玩得比谁都溜。
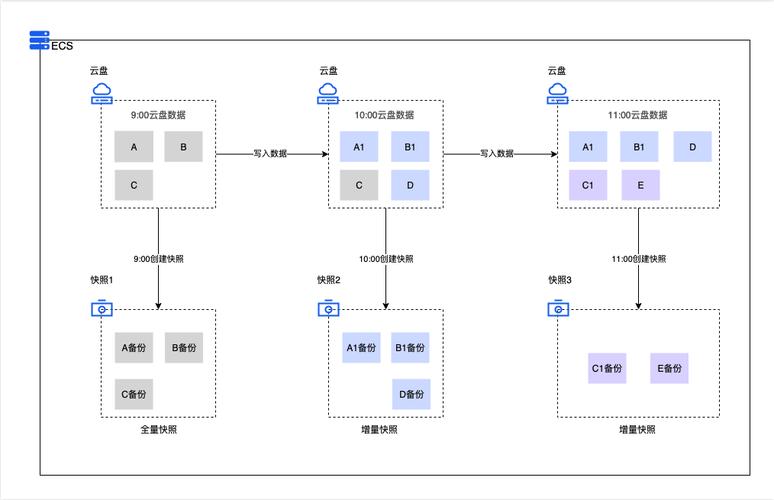 云数据库自动快照恢复操作流程图
然后第三类,异地灾备方案。
就是在相隔几百上千公里的另一个城市建备用机房,用来防地震、洪水、区域性电力故障这种极端风险。这东西的成本就更高了,一般是同城双活的3-5倍,只有金融、政务、核心医疗系统这种必须过等保三级的单位,才真的需要。
我见过不少小公司,被做等保测评的人忽悠,咬着牙上了异地灾备,一年多花大几十万,结果三年下来连一次灾备演练都没做过,钱全打了水漂。
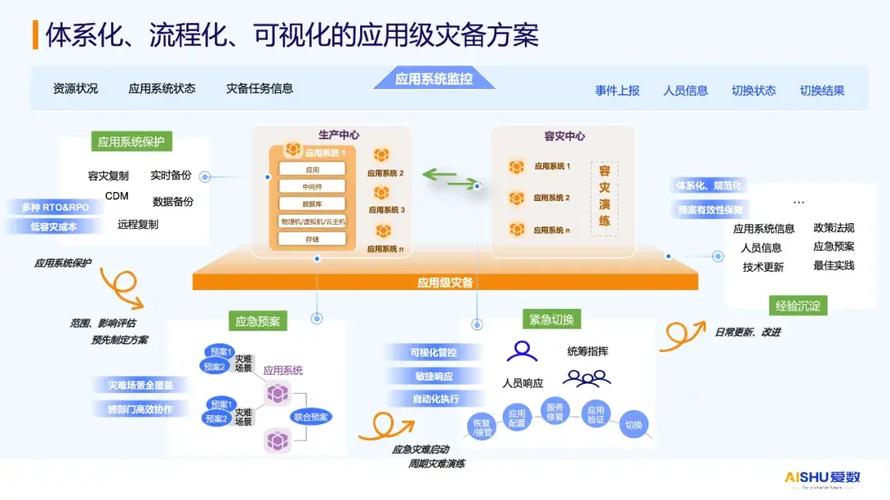 做灾备技术方案最容易踩的三个隐形坑
很多人觉得灾备就是买个服务,配好自动同步就完事了,根本不是,这里面的隐形坑能把人坑到哭。
第一个坑,只做备份,不做恢复演练。
很多团队每天定时自动备份,硬盘灯闪着,看着特别安心。真到要恢复的时候,才发现备份文件损坏,权限不对,数据库版本不兼容,根本读不出来。之前遇到个做直播MCN的团队,存了整整3个月的主播带货录像,每天自动备份,结果上次服务器被勒索病毒加密,要恢复的时候发现,备份的文件因为编码设置错了,全是花屏的,找了专业的数据恢复公司,花了16万才救回来一半的录像,悔得肠子都青了。
没有经过恢复演练的备份,本质上和没有备份没有区别。
第二个坑,灾备同步链路的带宽偷偷缩水。
很多供应商给你报方案的时候,写的是10G的专属同步链路,实际交付的时候,给你开的是1G的共享带宽。平时业务数据量小的时候,根本感觉不出来,真到要切流量的时候,几个T的数据同步慢得像蜗牛,RTO直接翻了好几倍。别等出事了才去查,每个季度抽个凌晨的低峰期,打个大文件测一下实际的同步速度,就啥都清楚了。
第三个坑,把灾备的责任全甩给运维团队。
很多老板觉得,我招了运维,买了灾备服务,就万事大吉了,真出问题就骂运维没用。其实根本不是那么回事。比如大促的时候,开发团队临时改了数据库的表结构,没同步通知灾备团队,真把流量切过去的时候,两边数据格式对不上,系统直接起不来,这锅算谁的?
得建立跨团队的灾备响应流程,每季度至少拉产品、开发、运维一起做一次模拟切换,谁的环节出问题,谁担责。
说实话,灾备这东西,从来不是越贵越好。
你得先算清楚,真出一次故障,你最多能扛住多大的损失,再去选对应的方案,别被销售一忽悠,就掏几百万上最顶配的集群。
真等服务器炸的那天,能快速把业务拉起来,把损失压到最低,才是真的有用。
上周老陈给我发消息,说他们上次吃了亏,花了8万做了一套适配自己业务规模的灾备技术方案,每季度练一次切换。上个月隔壁园区的机房因为消防故障断电,他们只用了11分钟就把全量业务切到了备用节点,连客户都没发现有过中断。
算下来,这8万花得比之前砸在营销上的几十万值多了。
他们公司做在线文档的,租的机房被施工队挖断了主干光缆,整个服务瘫了。
整整12个小时。
最后算下来,光客户违约金就赔了230多万,还丢了快两成的付费用户。
他跟我吐槽,之前也想过做灾备,看了好几个方案,觉得太贵,想再等等。
等就等出事了。
先想明白:你真的需要顶配的灾备技术方案吗?
很多人一提到灾备,第一反应就是“三地五中心”“双活集群”,觉得不上个百万级的方案就不算专业。扯什么呢。
先把两个核心指标搞懂:RTO(业务能扛住的最长中断时间),RPO(业务能接受的最大数据丢失量)。
比如你是做面向C端的生鲜电商,大促的时候系统挂10分钟,客户就要在评论区骂到关店,丢一笔订单数据都是实打实的营收损失,那RTO就得压到15分钟以内,RPO最好压到0。
但如果你是做内部用的考勤系统,就算挂个4小时,员工晚填个半天的打卡记录,也没人真的要跟你拼命,那RTO定个4小时,RPO允许丢1小时的数据,完全够用。
我见过最离谱的客户,给内部的打印机管理系统定的RTO是5分钟,RPO是0。
合着打印机晚启动5分钟,全公司人都要站在打印室等是吧?
纯纯的资源浪费。
不同规模企业灾备等级匹配对比表
别被销售绕晕:三类主流灾备技术方案的真实性价比
现在市面上的灾备方案,说来说去就三类,没有什么花里胡哨的新东西。第一类,本地级别的备份方案。
说白了就是定时把数据库、用户文件打包,存在本地的NAS或者云厂商的冷存储里,成本极低。我认识的一个独立开发者,做的是小众的宠物交流社区,就靠每周自动打一次数据库快照,一个月花的存储费才37块钱。上个月服务器被黑,对方把所有用户数据全删了,他花了1小时40分钟就把数据全恢复了,损失连两百块的服务器租赁费都没到。
第二类,同城双活方案。
就是在同一个城市,找两个相隔30-50公里的机房,两边同时跑一样的业务,网络打通实时同步数据,一个机房出问题,流量直接切到另一个,用户甚至感觉不到中断。这东西的成本大概是本地备份的6-10倍,适合用户量过百万的中等SaaS公司。
但这里有个天大的坑。
很多供应商拍胸脯说我们的双活RPO是0,一点数据都不丢。
扯。
跨机房的网络哪怕只有1ms的延迟,只要同步的时候网络抖一下,就会有几十毫秒的数据差,真遇到极端的链路故障,丢个几百条数据太正常了。去年有个找我咨询的客户,之前花了80多万上的双活,上次机房电力故障切流量,最后丢了327条客户的合同签署记录,找供应商扯皮,人家翻出合同指给他看——上面写的是“RPO趋近于0”。
文字游戏玩得比谁都溜。
云数据库自动快照恢复操作流程图
然后第三类,异地灾备方案。
就是在相隔几百上千公里的另一个城市建备用机房,用来防地震、洪水、区域性电力故障这种极端风险。这东西的成本就更高了,一般是同城双活的3-5倍,只有金融、政务、核心医疗系统这种必须过等保三级的单位,才真的需要。
我见过不少小公司,被做等保测评的人忽悠,咬着牙上了异地灾备,一年多花大几十万,结果三年下来连一次灾备演练都没做过,钱全打了水漂。
做灾备技术方案最容易踩的三个隐形坑
做灾备技术方案最容易踩的三个隐形坑
很多人觉得灾备就是买个服务,配好自动同步就完事了,根本不是,这里面的隐形坑能把人坑到哭。第一个坑,只做备份,不做恢复演练。
很多团队每天定时自动备份,硬盘灯闪着,看着特别安心。真到要恢复的时候,才发现备份文件损坏,权限不对,数据库版本不兼容,根本读不出来。之前遇到个做直播MCN的团队,存了整整3个月的主播带货录像,每天自动备份,结果上次服务器被勒索病毒加密,要恢复的时候发现,备份的文件因为编码设置错了,全是花屏的,找了专业的数据恢复公司,花了16万才救回来一半的录像,悔得肠子都青了。
没有经过恢复演练的备份,本质上和没有备份没有区别。
第二个坑,灾备同步链路的带宽偷偷缩水。
很多供应商给你报方案的时候,写的是10G的专属同步链路,实际交付的时候,给你开的是1G的共享带宽。平时业务数据量小的时候,根本感觉不出来,真到要切流量的时候,几个T的数据同步慢得像蜗牛,RTO直接翻了好几倍。别等出事了才去查,每个季度抽个凌晨的低峰期,打个大文件测一下实际的同步速度,就啥都清楚了。
第三个坑,把灾备的责任全甩给运维团队。
很多老板觉得,我招了运维,买了灾备服务,就万事大吉了,真出问题就骂运维没用。其实根本不是那么回事。比如大促的时候,开发团队临时改了数据库的表结构,没同步通知灾备团队,真把流量切过去的时候,两边数据格式对不上,系统直接起不来,这锅算谁的?
得建立跨团队的灾备响应流程,每季度至少拉产品、开发、运维一起做一次模拟切换,谁的环节出问题,谁担责。
说实话,灾备这东西,从来不是越贵越好。
你得先算清楚,真出一次故障,你最多能扛住多大的损失,再去选对应的方案,别被销售一忽悠,就掏几百万上最顶配的集群。
真等服务器炸的那天,能快速把业务拉起来,把损失压到最低,才是真的有用。
上周老陈给我发消息,说他们上次吃了亏,花了8万做了一套适配自己业务规模的灾备技术方案,每季度练一次切换。上个月隔壁园区的机房因为消防故障断电,他们只用了11分钟就把全量业务切到了备用节点,连客户都没发现有过中断。
算下来,这8万花得比之前砸在营销上的几十万值多了。