容错计算技术:你用的导航、刷的付款码,为啥敢‘算错’还不出事?
上周跟老周在江宁软件园旁边的苍蝇馆子吃皮肚面,他刚结束一下午的自动驾驶路测,把头盔往凳子上一扔,冰可乐灌了半瓶才开口。
说下午跑绕城的时候,车突然跳了个暗红色的故障码,副驾的实习生吓得手都要去拽紧急制动,结果车没偏、没停,慢悠悠打了右转向灯,顺着车道滑到应急车道上,稳稳停住。
查日志才发现,是左前轮的轮速传感器被路上溅的泥糊了,报了个假的转速信号。
我当时手里的皮肚面差点洒出来。
合着我们之前吹的什么“车端全链路智能”,根本不是什么百分百不会错的神,全是靠提前留的后手撑着的。
哪来的“故意出错”的技术?
很多人第一次听“容错计算”,第一反应是这技术是不是专门算错数的?
真不是。
说白了,这套技术从根上就不相信“计算系统永远不出错”这件事——毕竟不管是芯片、传感器、网络传输线路,你做的再精密,总有概率出问题:可能是太空里的宇宙射线打穿了芯片的一个存储单元,可能是夏天温度太高把传感器烤飘了,可能是网线被隔壁装修的师傅一电钻打穿了。
容错计算的核心思路特别简单:既然故障迟早会来,那我提前把后路铺好,哪怕某部分坏了,整个系统还能照常干活,不会直接瘫掉。
就像你考试的时候,知道自己某道题可能会写错,特意在草稿纸上留个备份的解题过程,等涂答题卡的时候要是发现主答案涂错了,直接照着草稿纸上的备份改,不会因为一道题涂错就交白卷。
老周他们的车为啥遇到泥糊传感器不慌?因为车身上装了三个不同原理的轮速传感器,一个被泥糊了报假数,另外两个正常的传感器算出来的结果一比对,就知道那个报错的是坏的,直接把它的信号屏蔽掉就行。
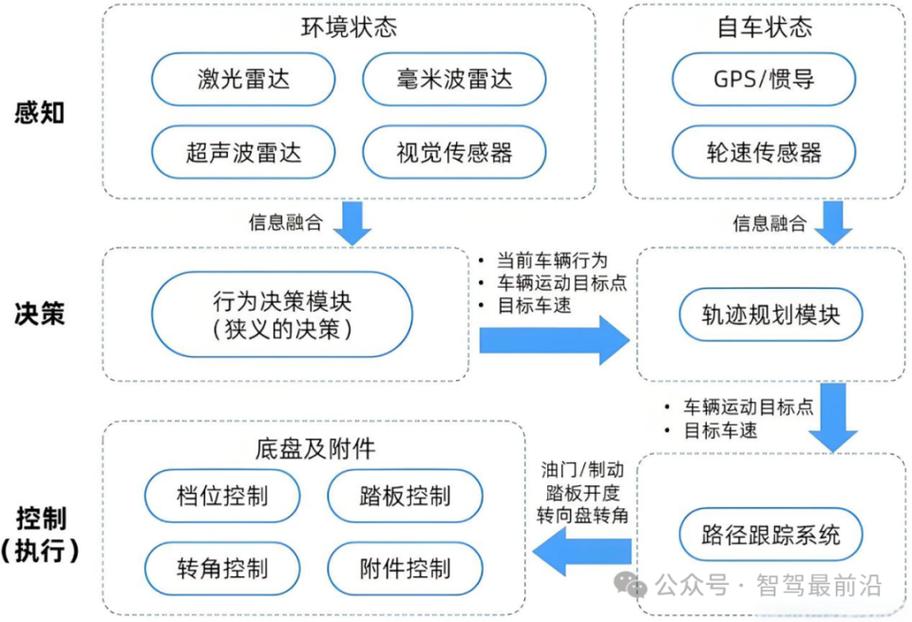 自动驾驶车端三余度传感器冗余架构示意图
我之前总以为车端的芯片算力拉满就能做到零失误,直到老周把他电脑里的故障日志甩我脸上,那上面密密麻麻记着过去三个月里,各个传感器报的大小故障,小到摄像头被雨点糊了半帧,大到某颗计算芯片突然掉了两核,没有一次是真的把车撂在半道上的。
太鸡贼了。
不是堆硬件,是跟“故障”玩心眼
我之前有个刚入行的实习生,看完老周的日志特别不解,说既然故障这么多,为啥不直接把硬件做的百分百可靠,非要搞这么多冗余?
我给他算笔账。
现在最顶尖的车规级芯片,失效率大概是每十亿小时工作时间出一次故障——听起来概率低到可以忽略对吧?但全中国有两亿辆机动车,每辆车平均一天开两小时,算下来每天就要出4次芯片故障。要是没有容错机制,这4次故障里只要有一次发生在高速行驶的状态,就是人命关天的事。
更何况,真要做百分百不出错的硬件,成本能翻十倍都不止。
所以真正的容错计算,从来不是傻呵呵的把三份一样的硬件堆上去,而是跟着故障的类型玩心眼。
最入门的玩法是双机热备:就像你家的主路由器坏了,旁边放个备用的,主路由一断网,备用的0.1秒就切上来,你刷短视频、开视频会根本感觉不到卡。
进阶点的玩法是计算过程实时校验:比如你在手机上点了一笔100块的转账,后台不是只让一个计算节点算结果,是三个节点同时算,三笔结果对得上,才把扣款记录写到数据库里。哪怕其中一个节点突然因为机房停电崩了,剩下两个节点算出来的结果一致,交易就照常走,你根本不会知道刚才那笔转账背后,有个节点直接宕机了。
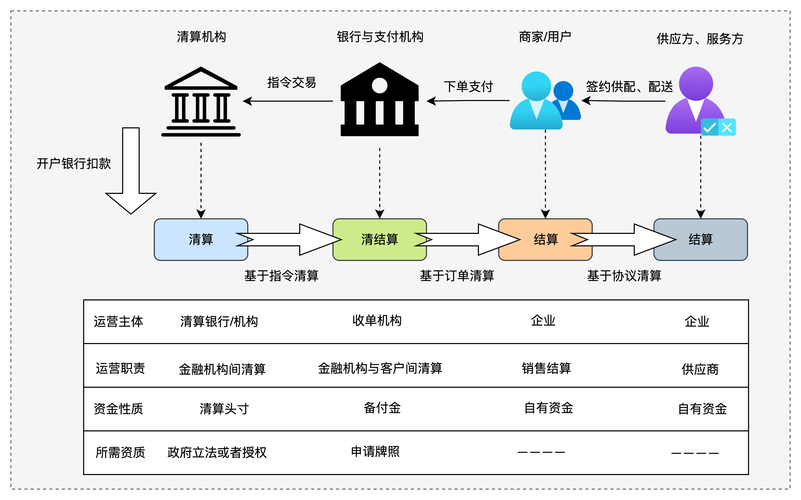 金融支付系统三节点共识计算流程示意图
我之前帮银行做过支付系统的容灾演练,当时故意在测试环境里拔了一台核心计算服务器的网线,我盯着屏幕上的交易流水,连0.01秒的卡顿都没出现,当时鸡皮疙瘩都起来了——原来我们平时点一下付款按钮,背后有这么多看不见的兜底动作。
当然也有笨的玩法。之前见过个做工业机械臂的厂商,为了凑“容错”的概念,直接给机械臂装了三个一模一样的角度传感器,结果车间里的焊渣飘上去,把三个传感器的镜头全糊住了,三个同时报一样的错误信号,系统以为是计算节点出了问题,硬扛着继续干活,最后机械臂直接把整个焊台怼穿了,损失了小几十万。
你看,光堆硬件没用,你得先想明白,哪些故障是会同时发生的,哪些是单独出现的,不然冗余堆的再多,也跟没装一样。
你根本注意不到的容错,早就藏在生活里了
很多人觉得容错计算是航天、军工、金融这种高大上领域才用的技术,离普通人远得很。
错了。
你每天刷卡进地铁站,有时候闸机屏幕突然黑半秒,然后“滴”的一声闸杆就抬起来了,你以为是闸机反应慢?其实是闸机里的主计算节点刚好抽风,备用节点0.3秒就切上来了,你那半秒的黑屏,就是切换的间隙,根本不会让你卡在闸机口进不去。
你刷短视频的时候,有时候地铁里网突然卡了两秒,视频没断,反而自动切了个清晰度更低的版本,等你出了地铁网好了,又自动切回高清——这也是容错的一种。它根本不追求网络永远满速,而是提前准备好降级方案,哪怕网断了、卡了,也不让你看视频的体验直接崩掉。
甚至你手机里存的照片、聊天记录,都是靠容错技术保住的。现在的手机存储,从来不是把一张照片完整存在一个存储块里,是把文件拆成好几份,分散存在不同的存储块里,再加个校验码。哪怕其中一个存储块因为长期用坏了,其他几个块拼起来,加上校验码补全缺失的部分,还是能还原出完整的照片,你根本不会发现自己的相册里少了半张图。
说真的,我之前换手机导数据的时候,特意翻了翻旧手机的存储日志,发现过去三年里,已经有三个存储块因为寿命到了坏了,要不是有容错机制,我存了好几年的猫片早就没了。
当然容错不是万能的。
它只能扛你提前预判到的故障。如果你连故障会怎么发生都想不到,那再多的冗余也兜不住。比如之前有次大暴雨,整个机房的备用供电系统都被淹了,你备再多的服务器也没用,电都没了,啥系统都得停。
我见过太多项目把容错当万能膏药,不管什么场景都往上堆冗余,最后钱花了几百万,真遇到没预判到的故障,照样趴窝。
上周再跟老周吃皮肚面,他说他们现在在搞新的容错方案,让车端能扛已知的故障,遇到没见过的故障时,也能自己临时凑个能用的解决方案。
我当时听着觉得挺玄,转头就把自己车上的胎压监测报警给消了——反正就算传感器坏了,容错系统也能帮我兜着。
哦不对,还是得自己多检查轮胎。
毕竟技术再好,也架不住人偷懒。