自主系统研发:从实验室demo到产业落地的可控性缺口
上周在紫金山实验室跟做无人集群的团队聊,他们刚把一套在封闭试验场跑了3个月的无人车拉到江宁的开放路测段。
当天就撞了路边的隔离桩。
没有戏剧性的故障,就是系统识别到隔离桩的时候,已经晚了0.2秒。
那个团队的工程师蹲在隔离桩旁边拍剐蹭痕迹的时候,脸都垮了——之前在实验室里测了1200组极端避障场景,算法输出的碰撞概率从来没超过0.1%,结果一到真实道路上,直接给了个满值。
为什么试验场里的“完美表现”一出门就垮
很多人对自主系统的认知,还停留在科幻电影里那种能自主决策、灵活应对所有场景的智能体。但实际做过落地的人都知道,绝大多数封闭环境下训练的自主系统,本质是对固定规则集的拟合,而非对开放世界不确定性的感知能力。
试验场的环境是被人为简化的:路面没有散落的杂物,路边的障碍物是固定位置的锥桶,所有参与测试的交通参与者,都是按照预先设定的路线和速度移动的。在这种环境下调出来的算法,本质上是在解一道有标准答案的数学题,只要把参数调对,拿到满分是迟早的事。
但开放道路不是考场。
路上的外卖骑手可能为了赶单突然变道,雨天的路面积水会反射阳光干扰摄像头的识别精度,路边的广告牌光影可能刚好和某个交通标志的视觉特征重合。这些变量没有办法被完全枚举,更不可能被提前放进训练数据集里。那个无人车团队的工程师算过一笔账,要把开放道路上的所有可能场景覆盖到,需要的数据集规模是现在封闭测试集的1700多倍——就算真的攒出来这么大的数据集,算法在训练的时候也根本学不完。
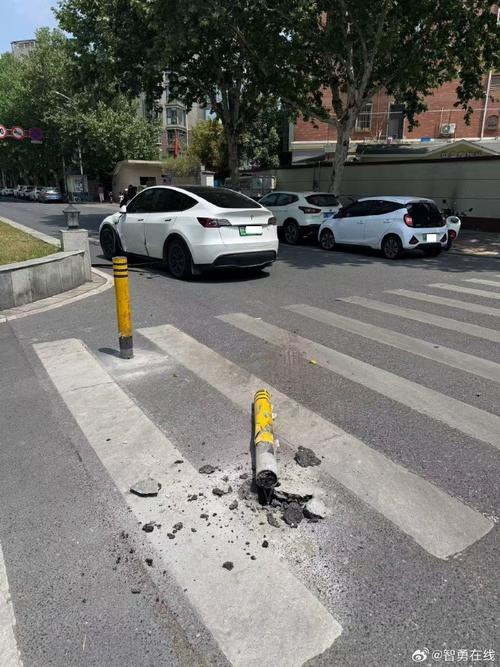 南京江宁开放道路无人车测试现场隔离桩剐蹭痕迹
之前接触过一家做仓储自主移动机器人的企业,一开始把产品铺在封闭的标准仓库里,运行得特别顺畅。后来想拓展业务,把同一套算法的机器人拉到露天的快递分拨中心,刚上线就堵了整条分拣线。
原因说出来很可笑:分拨中心的地面上散落着大量的快递面单、透明胶带和塑料包装,机器人的视觉系统把这些薄而反光的东西识别成了需要避让的障碍物,就停在原地不动,后面的机器人也跟着堵成了一串。算下来那次试错,光分拣延迟带来的货损就有大几十万。
这其实就是现在自主系统落地里最常见的认知偏差:把“在特定简化环境下的稳定运行”,等同于“系统具备了自主决策的通用能力”。
别拿大模型当自主系统的“万能补丁”
最近两年大模型火了之后,很多做自主系统的团队像抓住了救命稻草,觉得只要把多模态大模型接到自主系统的感知层后面,就能解决开放场景的识别问题。
想法很美好。
但实际测过就知道,通用大模型的训练目标是生成符合人类语言逻辑的内容,而非对物理世界因果关系的精准映射。这两个目标从根上就不一样。
之前跟电力行业做自主巡检机器人的团队聊,他们去年试过把一套主流的多模态大模型接到巡检机器人的识别模块上,本来想靠大模型解决变电站里复杂设备的识别问题,结果第一次现场测试就出了问题:机器人看到穿蓝色工作服的运维人员,直接识别成了“带蓝色绝缘套的高压母线”,把巡检路线自动切到了带电设备的安全距离内,差点触发安全告警。
你说大模型认不出穿蓝衣服的人吗?它在文本和图片数据集里见过成千上万张穿蓝衣服的人的照片,写出来的描述能比人还细致。但它不知道的是,在变电站的场景里,穿蓝色工作服的人是移动的,高压母线是固定的,这两个东西的物理属性差异,是它靠文本和图片的匹配永远学不会的——因为它从来没有在真实的物理世界里,建立过“位置、移动速度、热辐射、声音”这些多维度的因果关联。
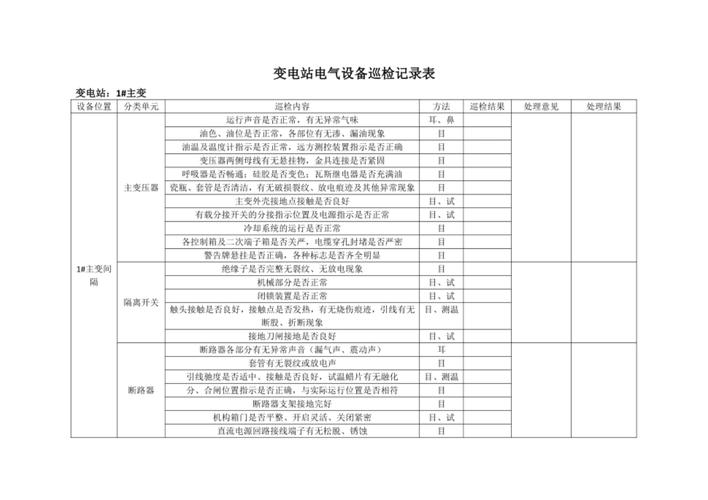 变电站自主巡检机器人带电设备识别偏差测试记录
更要命的是大模型自带的幻觉问题。
在自主系统里,幻觉不是写一段不通顺的文字那么简单,是可能直接引发安全事故的决策偏差。比如之前测的一套基于大模型的自主园区配送机器人,碰到路边的垃圾桶,就识别成了“需要绕行的临时障碍物”,绕的时候压到了路边的草坪,把刚铺的草皮压坏了。工程师调了半天参数才发现,大模型训练的时候见过太多“垃圾桶旁边需要绕行”的文本描述,根本没注意到那个垃圾桶是固定在地面上的,根本不需要绕。
之前跟做嵌入式系统的老周聊,他说现在很多团队做自主系统,上来就堆硬件:车上装8个激光雷达,12个高清摄像头,算力卡堆到4块,总算力算下来有上千TOPS,结果算出来的决策延迟是200毫秒。在高速场景下,这个延迟意味着车辆在120公里时速的时候,会多往前跑出去6.7米。这个距离,足够出一次致命的事故了。
落地的边界,从来不是技术能到哪就算哪
 落地的边界,从来不是技术能到哪就算哪
我见过太多做自主系统的团队,在产品介绍PPT里写满了“全场景覆盖”“完全自主决策”的宣传语,恨不得把从矿山巡检到城市配送,从农业耕种到家庭服务的所有场景都做一遍。
但实际上,自主系统的风险是分布式的。
你根本不知道哪个微小的识别偏差,会在哪个特定的场景里酿成大的事故。比如之前做农业自主拖拉机的团队,在华北平原的大块平整农田里测试得好好的,把机器拉到南京丘陵地区的梯田里,因为田埂的坡度比试验场高了3度,拖拉机的姿态传感器就出现了数值偏差,差点翻到田埂下面。
自主系统的研发边界,必须和对应的风险承受能力严格匹配,不能为了追求技术上的“自主程度”,把不可控的风险转嫁给最终的使用者。
在封闭的矿山作业区,整个区域是没有无关人员进入的,作业路线是固定的,自主系统的自主程度可以做得相对高一点——哪怕系统出了偏差,影响的范围也只在作业区内部,不会波及到公共安全。但如果是在城市的开放道路上,自主系统的自主程度就必须严格受限,必须保留独立的安全冗余回路,必须有随时可以触发的远程接管机制,不能为了追求“更智能”的卖点,把乘客的安全赌在还没经过足够场景验证的算法上。
说实话,我之前也觉得,自主系统的发展应该朝着“完全不需要人干预”的方向走,直到上次在江宁路测的时候,碰到那个蹲在隔离桩旁边的工程师。他说他们团队现在改了研发思路,不再追求把所有场景都覆盖了,先把园区内部的固定路线跑稳,把决策延迟降到50毫秒以内,把独立的安全制动回路做好,等这些基础的东西都磨扎实了,再慢慢拓展到周边的开放道路。
不过话说回来,这也没什么不好。
硬科技的落地从来不是靠拍炫酷的demo就能成的,得一笔一笔算清楚账,哪个环节的可靠性够了,哪个环节还有风险,哪个地方需要留个人工干预的口子。毕竟用户买一套自主系统,不是为了看算法有多先进,是为了让系统安安稳稳地把该干的活干完,不出乱子。
上个月在南京的半导体产业博览会上,碰到几个做自主系统核心控制芯片的工程师,他们说现在的研发方向已经不是追求更高的峰值算力了,而是在优化芯片的实时响应能力,哪怕峰值算力低一点,只要决策延迟够低,运行够稳,就是适合自主系统的好芯片。
其实想想也是。
自主系统的“自主”从来不是目的,是手段。你把系统做的再智能,要是控不住,那还不如做个简单点的,能稳稳当当干活的系统靠谱。