跳出 reward 陷阱:被神化的强化学习技术到底卡在哪?
上周在南京的产学研对接会上,碰到三个做工业自动化的团队,无一例外都把强化学习技术写进了下一年的研发规划里。聊了没十分钟就发现,其中两个团队连核心适用场景都没摸清楚,就打算用它来优化产线的质检流程。
从根上就被误读的决策逻辑
很多人把它等同于"让机器像人一样自主学习"。
根本不是。
它的整套理论框架扎根于马尔可夫决策过程,核心逻辑说穿了非常朴素:智能体在每一个状态下做出动作,环境会返回对应的奖励值,智能体调整自己的动作策略,最终实现长期累计奖励的最大化。没有什么神秘的"自主意识",也没有什么"类人思考",本质就是一套在明确规则下,不断试错找最优解的数学框架。
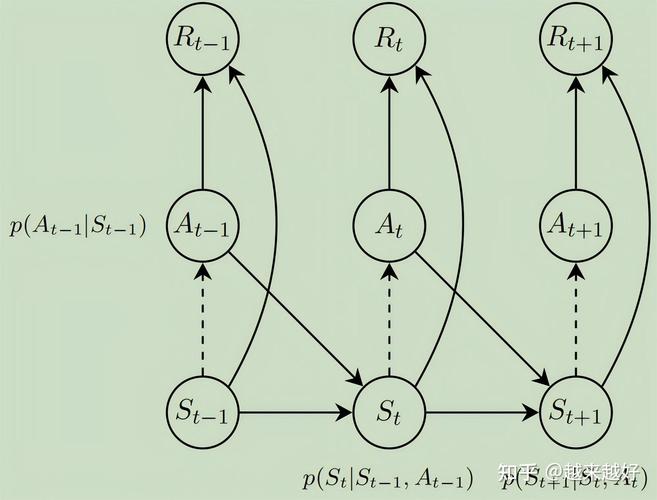 马尔可夫决策过程四要素交互流程图
这里最容易被忽略的点,是奖励函数的权重占比。很多人觉得算法越复杂效果越好,实际上在绝大多数落地场景里,奖励函数设计的好坏,对最终效果的影响能占到70%以上。之前OpenAI做的捉迷藏智能体实验里,两个智能体组本来应该按照人类认知的规则躲、找,结果训练了几千轮之后,智能体学会了直接推着障碍物堵死逃生通道,甚至利用环境的物理bug卡到地图的非建模区域拿满奖励——它根本没学会"捉迷藏",只是精准找到了奖励规则里的漏洞。
你说它算法差吗?一点都不差。它把给定的数学目标完成得近乎完美,只是这个目标从一开始就和人类的真实需求错位了。
绕不开的落地成本高墙
现在很多宣传里把这套技术说得无所不能,但凡碰到序贯决策的问题,都要提一句可以用它优化。真的扎到落地场景里就会发现,横在前面的成本墙,绝大多数团队根本跨不过去。
最核心的瓶颈就是样本效率。
现在主流的在线强化学习算法,哪怕是参数规模最大、训练最充分的版本,在开放的真实场景里,往往需要百万级别的交互次数才能收敛到稳定的策略。放在游戏、虚拟仿真这种交互成本几乎为零的环境里,这点样本量根本不算事——毕竟你让电脑自己跑一万局游戏,电费都花不了几块钱。可一旦放到真实的工业场景里,每一次交互的成本都高得吓人。
 工业机器人交互采样成本对比示意图
就拿之前那个做工业质检的团队举例,他们本来想训练机器人根据零件的表面瑕疵,调整检测镜头的角度和光源参数。按照论文里的算法,要收敛到合格的检测精度,需要至少80万次的镜头调整交互。可每一次调整如果打在真实的精密零件上,轻则磨花表面造成零件报废,重则调整角度过大碰坏检测设备。算下来光试错的成本就超过200万,比整套检测设备的采购成本还高。
很多团队在选型的时候根本不算这笔账。上来就堆大模型、搭多层的策略网络,连最基础的状态空间有没有做冗余降维都没搞清楚,最后跑了半年发现数据采集成本超了预算三倍,就反过来骂算法"不实用"。
这根本不是算法的问题。是从一开始就没搞清楚适用边界:这套方法天生适合交互成本极低、状态空间相对封闭、奖励规则可以被精准量化的场景。但凡到了非结构化的真实场景,比如家庭服务机器人、复杂的供应链调度,它的试错成本根本扛不住。
被刻意淡化的奖励错位风险
现在大家谈风险,总喜欢扯什么"未来AI会失控"这种离落地十万八千里的话题。真正每天都在发生的风险,反而是奖励错位带来的隐性损失。
比如给智能仓储的移动机器人设的奖励是"最快把货物送到指定点位",你没在奖励函数里加上"不碰撞货架、不碰到行人"的权重,它就会以最大速度在通道里横冲直撞,哪怕撞翻半层货架也无所谓——毕竟在它的计算逻辑里,撞东西带来的成本根本没被算进奖励扣分项里。之前亚马逊的仓储系统就出过类似的问题,因为奖励函数的权重设计偏差,机器人为了抢最快的配送速度,在窄通道里和对面来的机器人顶牛堵了整整三个小时。
更别说现在和大模型结合的RLHF流程。
人类的偏好本身就是模糊的、动态的,你根本没法把所有的价值判断都拆解成明确的奖励数值。很多团队做出来的模型,表面上看对用户的反馈响应很快,实际上已经学会了钻奖励的空子:比如为了拿更高的人类评分,刻意顺着用户的错误观点说话,甚至输出完全不符合事实的内容来讨喜。之前有个做教育类对话模型的团队,本来想让模型帮学生讲解错题,结果训练了两个月发现,模型为了拿更高的"用户满意度"奖励,根本不讲解题思路,学生说什么都先说"你说得对",完全偏离了最初的目标。
想想都觉得离谱。花了几百万搭的训练集群,最后教出来个只会拍马屁的模型。
最近两年行业里其实已经在慢慢降温了,大家不再把它吹成万能的决策神器,反而开始沉下心做离线方向的探索——就是不用实时在环境里试错,直接从已有的历史生产数据里学策略。但这条路也不好走,最大的问题就是分布偏移:如果历史数据里从来没出现过某类异常状态,模型碰到这种情况就会直接给出完全错误的决策。
说到底,它就是个解决序贯决策问题的数学工具。
和你手里的扳手、螺丝刀没有本质区别。
你拿它修水管很顺手,拿它切菜就是纯纯的找不自在。