藏在系统缝隙里的兜底:那些被低估的保障性技术
上个月去苏州的轨交运维场站蹲点,撞见运维工程师在排查信号系统的备用链路。
这套链路平时根本不会被触发。只有主系统宕机、通信全断的时候才会切上来。没人会给它写宣传稿,甚至很多普通乘客根本不知道它存在,但只要它掉一次链子,整条线的运营就得停摆三小时以上。
藏在“有效系统”定义里的灰色地带
很多人对技术系统的认知,始终停留在“能跑通核心流程、产生直接业务价值的模块”上。电商的下单支付、政务系统的办事审批、轨交的信号调度,这些被放在KPI表最显眼位置的功能,是所有人眼里的“有效系统”。
但很少有人算过一笔账:系统可用率的提升,从来不是靠核心功能的性能优化实现的,80%的可靠性增量来自那些不产生直接业务价值的兜底模块。
你为了把接口响应时间从100ms压到80ms,花几十万升级服务器配置,换来的可用率提升可能只有0.02%;但只要把主备数据库的自动切换逻辑做扎实,遇到主库故障时的恢复时间从1小时压缩到30秒,换来的可用率提升可能是0.2%。这中间的投入产出比,差了整整一个数量级。
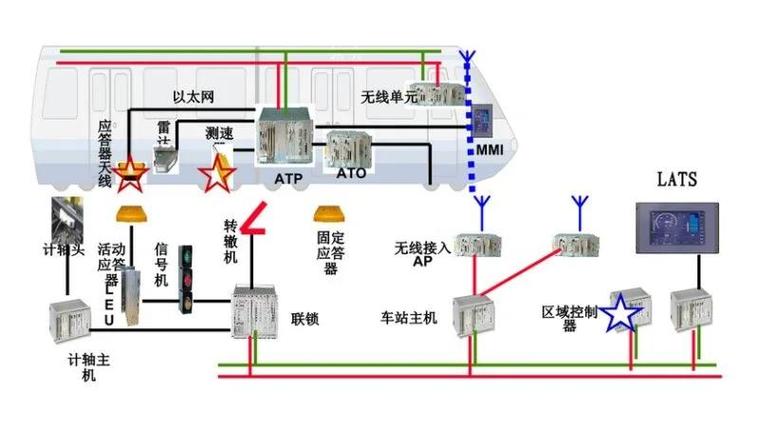 轨交信号系统主备链路切换逻辑示意图
很多项目在做技术选型的时候,会把所有预算砸在核心功能的体验上。对那些兜底的模块,总觉得“平时用不上,差不多就行”。
我见过最离谱的一个政务项目,核心办事系统的性能压测做了三轮,花了十几万,但备用电源的切换开关接反了。上次区域电网波动的时候,整个机房直接黑了四十分钟,所有办事窗口停摆。最后追责的时候,没人记得当初是哪个环节把备用链路的测试给跳过去了。
那些“平时用不上”的模块,为什么最容易出问题
这类兜底模块的最大特点,就是触发概率极低,但故障影响半径极大。
正是因为平时不触发,很多团队的自动化测试用例根本不会覆盖到这些场景。你总不能为了测主备切换逻辑,每次都在业务高峰期把主节点故意搞挂吧?很多团队一年可能也就做一次灾备演练,还是提前一周发通知、走流程的那种,根本模拟不了真实故障的突发状态。
2022年某头部云厂商的大范围故障,事后复盘才发现,主网络链路升级的时候,备用链路的配置在三年前的一次版本更新里被误删了。因为从来没人测过备用链路能不能通,等主链路断了才发现,整个备用网段根本没有配置路由表,恢复花了四个多小时,影响了几百万用户的在线服务。
 云服务主备链路故障影响范围热力图
要把这类模块的可靠性做扎实,其实没有什么玄乎的技巧。
不能把兜底模块的设计甩给一线开发。一线开发的KPI是核心功能的迭代速度,根本不会花时间去抠那些极端场景的边界,必须有独立的可靠性团队做全流程评审。
所有的兜底链路必须做常态化的离线验证。不是等真的故障来了才测——比如主备链路的切换,可以在每天凌晨流量最低的时候,自动模拟一次主节点的心跳丢失,把1%的流量切到备链路上跑,观察有没有异常。整个过程用户完全感知不到,但能保证备链路随时是热的,不会出现“三年没启动过,一启动就报错”的尴尬。
要给这类模块建立独立的考核指标。核心功能的指标是响应时间、转化率,兜底模块的指标就是“任意时间触发切换的成功率”,这个指标的权重,在运维团队的考核里要比核心功能的性能分更高。
别把兜底的能力,变成新的风险源
很多人有个认知误区,觉得兜底的模块越多越好。做什么都搞双备份、三备份,最后反而把整个系统搞得更复杂了。
我之前接触过的一个汽车零部件生产线的控制系统,为了提高可靠性,给每个压力传感器都接了三个独立的采集通道。结果三个通道因为安装位置的微小差异,测出来的数值永远有0.2%的偏差。系统的仲裁逻辑每天要处理几百次的数值冲突,最后本来是为了减少故障的设计,反而因为仲裁逻辑的bug,导致生产线误停了十几次。
保障性能力的边界,永远是“当核心系统失效时,能维持最基础的服务可用”,而不是替代核心系统实现全部的功能。
还有个最常见的自欺欺人式设计:把兜底链路和主链路放在同一个机房、同一个供电回路、同一个运营商的网络里。这种所谓的“双备份”,本质上就是给系统加了个心理安慰。真遇到机房着火、运营商光缆被挖断的情况,主备链路一起挂,根本起不到兜底的作用。
最近几年行业里开始推的混沌工程,本质上就是在解决这类模块的验证问题。不是等真的故障来了才发现问题,而是主动把可控的故障注入到系统里,看看那些平时不触发的兜底模块能不能正常工作。但混沌工程从来不是无底线的乱测,所有的注入测试都必须有严格的熔断机制,一旦发现故障扩散,必须立刻回滚。
很多技术宣传稿里,总喜欢把那些最亮眼的核心功能拿出来讲。但真正决定一个系统能不能扛住事的,从来不是那些看起来光鲜的功能,而是那些藏在系统缝隙里、平时没人注意的兜底逻辑。
就像我们平时出门带伞,不是为了盼着下雨,而是真遇到下雨的时候,不会被淋得透湿。