从数字敦煌到AI策展:文化创意技术的落地盲区与真实路径
上个月去杭州看的那个数字展,花了98块门票,进去满场的LED屏滚着飞天的动态投影,伸手就能碰出漫天的金粉,旁边的小朋友追着投影跑了三圈,出来问我"敦煌的姐姐是不是真的会飞"。
站在展厅出口的时候我在想,我们花了这么多钱做出来的数字展,到底是在传播文化,还是在做一场大型的光影游乐场。
被高估的‘技术赋能’
很多项目对文化创意技术的认知,还停留在"把老东西搬上屏幕"的阶段,根本没触碰到技术的核心作用机制。
之前去过某县级的非遗馆,斥资几百万做了全套的VR体验设备,让观众戴着眼罩走"虚拟苏绣工坊"。我当时戴着眼罩,差点被旁边的电线绊倒,摘下来一看,绣娘的虚拟形象连基本的持针姿势都不对——苏绣劈丝要把一根蚕丝劈成1/16,动画里的手攥着整根线在布上乱划,连最基础的针法对应都没做对。说实话,我不是反对VR进展馆,我是反对花大价钱做一堆根本没做功课的粗制滥造内容。
真正跑通了的项目是什么样的?比如敦煌研究院做的壁画色彩复原交互系统,不是把高清扫描图投在墙上,而是通过色谱分析,把不同朝代壁画的矿物颜料配比、褪色规律、当时洞窟内的油灯照明亮度都做成可调节的参数集。观众可以滑动滑块,看初唐时期的洞窟在烛光下的真实色彩,而不是现在我们看到的、被氧化褪成土黄色的残迹。
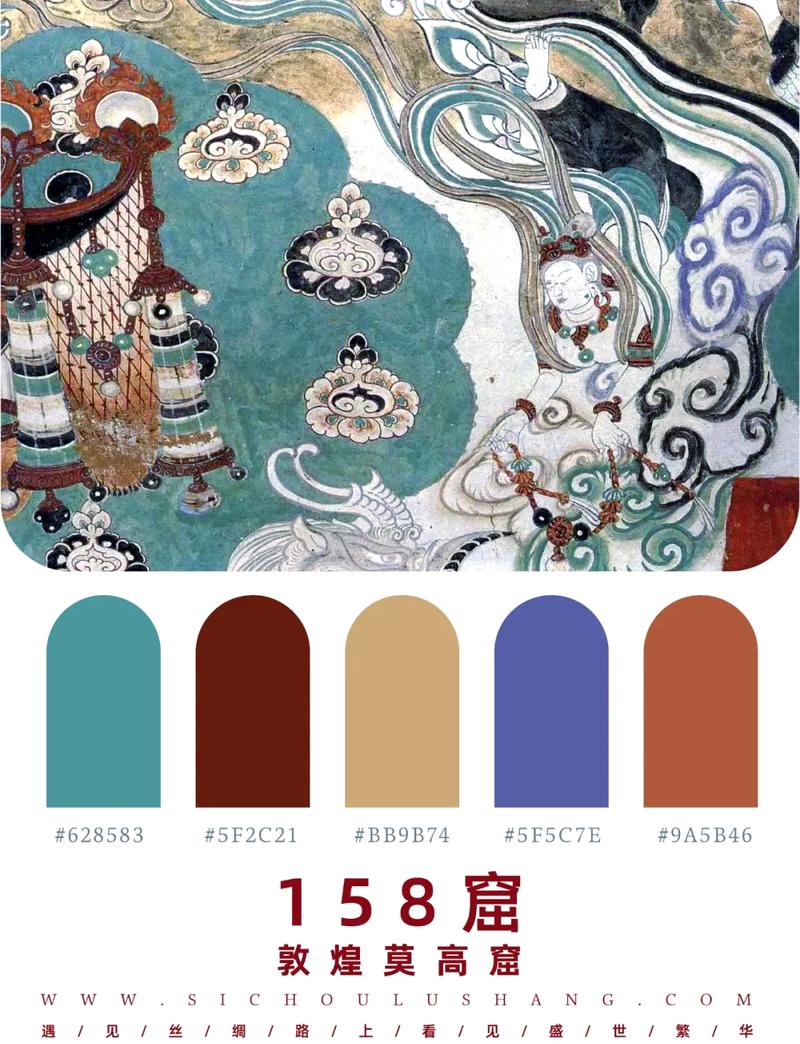 敦煌壁画矿物颜料色谱分析交互界面
这才是真的有用。
很多项目宁愿把预算砸在大尺寸LED屏、进口VR头显这些看得见摸得着的硬件上,也不愿意花几个月时间蹲在洞窟里,跟着修复师一笔一笔记录壁画的线条弧度、颜料层次,本质上是把技术当成了可以快速复制的装修材料,而不是需要和文化内容深度耦合的生产工具。说穿了就是懒。反正硬件的钱花出去,账面上好看,至于内容对不对,好像没人真的在意。
技术落地的隐形门槛
文化创意技术的落地,从来不是技术团队单方面的事,它需要文化端的专家把隐性的工艺知识拆解成可被技术团队理解的显性规则,而这个过程没有任何捷径可走。
去年和一个做元宇宙文创的团队聊,他们本来想做南京云锦的数字藏品项目,一开始找了纯计算机背景的团队,跑了三个月生成的纹样,被云锦研究所的老师直接打回来——所有的纹样都没有考虑云锦"挑花结本"的工艺限制,那些看起来很美的对称云纹,现实里根本没法用大花楼木织机织出来,因为挑花的结本要按照经线的排列顺序逐行记忆,复杂的曲线如果超过了结本的记忆长度,织出来就是歪的。
后来这个团队换了思路,没有一开始就想着做数字藏品卖钱,而是先跟着云锦的传承人做了三个月,把每一个工艺环节的约束条件都列成了清单:比如云锦的金线不能折超过3次,折多了就会断;宋锦的纹样在不同的光照角度下会有不同的光泽;大花楼织机的提花需要两个人配合,上面的拽花工每提一次花,下面的织手就要投一次梭。最后他们做出来的交互装置,没有用什么复杂的投影,就是在展台上放了一块可以手动转动的织机模型,旁边的传感器实时捕捉转动的角度,在屏幕上对应生成织机上正在织造的纹样,观众转的越快,纹样生成的速度就越快,旁边配的解说也不是讲"我们用了什么高精度传感器",而是讲"你现在转的这个把手,就是几百年前织工每天要转上万次的部件,每转一圈,经线就往前挪一梭"。
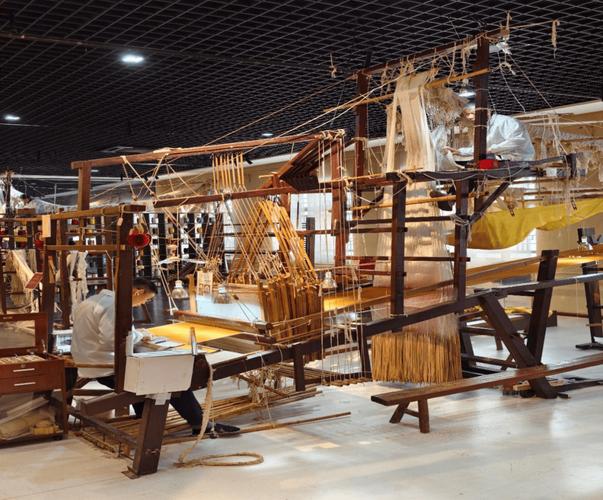 南京云锦大花楼木织机交互装置现场
这个项目的成本,还不到之前那个VR苏绣项目的十分之一,但观众的平均停留时间是那个VR项目的七倍。
没人会记得你用了多少技术。但观众会记得,自己伸手转动把手的时候,突然懂了为什么云锦被称为"寸锦寸金"——不是因为材料贵,是因为每一寸布的背后,都是织工几千次机械重复里攒出来的手工温度。
不过话说回来,技术也不是万能的。它有明确的应用边界:那些需要安静品读的碑刻书法,你非要在旁边装个传感器,人一走近就放书法的动画音效,反而会破坏那种沉静的氛围。之前去看的一个书法展,整个展厅黑黢黢的,每块碑刻前面都有个动态的毛笔书写投影,配着唰唰的写字音效,我站在那十分钟,根本没看清碑上写的什么字,满耳朵都是唰唰的声音,最后只好逃出去。这种场景下,最好的技术就是没有技术,给观众留一盏足够亮的灯,一块可以安静站着读字的地方,就够了。
绕不开的长期风险
 绕不开的长期风险
如果把文化创意技术当成可以批量复制的标准化生产工具,最后只会把本来有地域差异性的文化内容,磨成没有记忆点的工业流水线产品。
现在走在长三角的各个古镇,夜游项目的套路几乎一模一样:入口处是水幕电影,主街两边是挂在树上的动态投影,核心广场是几分钟的灯光秀,除了投影上印的本地名人名字不一样,整个体验流程毫无差别。看多了根本记不住哪个是哪个,最后所有的古镇都变成了一个模子里刻出来的光影布景。
还有版权的暗坑。现在很多用AI生成文创内容的项目,训练模型用的素材都是没有经过授权的,比如把古代画家的作品喂给模型生成新的文创图案,看起来好像是没有版权问题,但如果生成的图案和某个在世的设计师的作品相似度超过30%,后续的纠纷根本扯不清。之前有个做文创盲盒的团队,用AI生成了一批国风图案,上线卖了两周就被设计师起诉,说其中三个图案和自己之前的获奖作品几乎一模一样,最后赔了八十多万。这种坑,根本不是靠技术能力就能填上的。
现在行业里其实已经在慢慢调整方向,大家不再追求做最贵、最炫的技术装置,而是开始找技术和文化内容最适配的那个点。比如做古籍数字化的项目,不是把所有的书都扫成PDF就完事,而是给每一页古籍加上可交互的注释,读者用手指点一下页面上的异体字,就能跳出来这个字在不同朝代的写法变化,还有对应的版本校勘记录。这个功能没有什么复杂的技术,就是把之前专家做的校勘笔记,做成了可点击的超链接,但读者的阅读体验比对着PDF逐字逐句看要好太多。
上次和那个做云锦交互装置的团队吃饭,他们说之前本来想拉投资的时候,准备了几十页PPT,要给投资人讲"我们用了什么物联网技术,什么实时交互算法",结果后来直接把织机模型搬到了路演现场,让投资人自己转了五分钟把手,当时就拿到了意向投资。
哪有什么玄学。
大家其实都看够了那些飘在半空的技术概念,真正能打动人的,从来不是技术本身有多炫,而是你用技术接住了那些本来快要被遗忘的细节——比如织工转把手的力度,比如敦煌洞窟里油灯晃出来的光影,比如古籍上被前人圈出来的那句批注。