开源技术应用:从代码仓库到生产链路的落地暗礁
上周跟南京本地的制造企业CTO吃饭,他吐槽说花了3个月把一套开源的时序数据库搭起来,压测的时候跑得比商用库还顺,结果真上生产线跑了两周,整个车间的设备数据采集直接卡成PPT——不是代码有问题,是没人注意到开源协议里藏的商用授权限制,还有社区版本默认关掉的高可用模块,要开就得付十几万的授权费。
被简化的"零成本"叙事
很多人对开源的认知还停留在"代码免费、随便用"的阶段。说真的,我见过太多团队把"用开源"当成了技术先进性的证明,结果连社区的issue区都没翻完,就敢把代码往生产环境塞。开源技术的落地成本从来不是代码本身的授权费用,而是从选型、适配、运维到风险兜底的全链路隐形成本。
去年有个做工业互联网的创业公司,把一个已经停更了18个月的开源边缘计算框架用到了客户的项目里。一开始算成本的时候,只算了服务器的采购钱,觉得代码是免费的,能省一大笔开发费。结果框架里藏的内存泄漏问题没人修,导致客户的能耗监测系统每个月都要宕机3次,最后整个项目的尾款全扣了,还赔了客户的生产损失违约金。算下来,整个项目压根没赚钱,还倒贴了近百万。
很多宣传材料里把开源的成本算得只剩代码授权费,刻意回避了维护成本。你要是用了一个社区项目,就得配专门的工程师盯着版本更新,碰到bug要自己定位修复,还要跟进供应链的安全漏洞。这些成本,从来不会写在开源仓库的首页上。
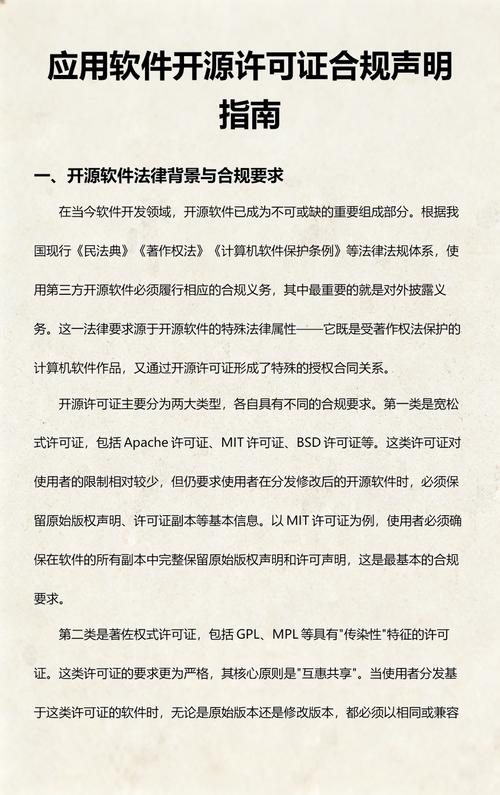 开源软件商用授权协议合规检查流程表
生产环境里的"非技术坑"
很多人以为开源落地的问题都是代码bug,其实大部分踩过的坑,都和代码本身没关系。
比如很多中小团队在做客服系统的时候,会选开源的大模型推理框架。代码是真的好用,推理速度比商用API快三倍,还能私有化部署。但很少有人注意到,框架的默认参数是面向通用场景设计的——对金融、医疗这类强合规领域的要求根本不支持。举个例子,开源框架默认的上下文缓存策略是全量存储72小时,这意味着用户输入的身份证号、银行卡号、病历信息都会被存在服务器的本地缓存里。这要是碰到监管检查,直接就触碰了数据合规的红线。
还有个容易被忽略的点:很多开源项目的社区版和商用版,是故意留了功能缺口的。这不是维护者故意坑人,是开源项目本身需要可持续的收入来支撑长期迭代——靠个人捐赠根本养不起核心维护团队,只能靠商用授权的收入来覆盖开发成本。比如你用社区版做高并发的业务场景,会发现限流模块的阈值被锁死在每秒1000次请求,要放开就得购买商用授权。很多团队一开始算成本的时候,根本没把这笔潜在的授权费算进去,等业务量上来了,才发现自己被架在了半空中。
别觉得用了开源就一定比自研灵活。我接触过的一个做智慧校园的项目,本来想自研一套校园卡消费系统,后来选了开源的版本,改了3个月,发现代码里的耦合度比自己写的还高——原作者的代码是为了适配普通高校的一卡通场景写的,根本没考虑到校园里还要对接门禁、图书馆借还、食堂消费的多系统数据打通。改到最后。人麻了。相当于把整个框架重写了80%,还不如一开始就自研。
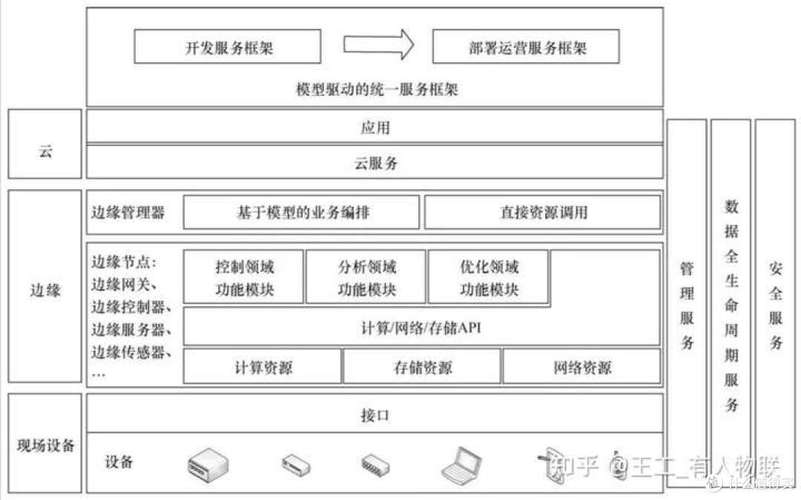 开源边缘计算框架生产环境部署架构图
被忽略的应用边界
开源技术不是万能药。开源技术的适用边界,本质上是社区生态的覆盖范围,而不是代码功能的覆盖范围。
在通用的Web开发场景,开源框架的成熟度确实很高,因为社区里有无数开发者踩过坑,任何问题你搜一下都能找到解决方案。但在特殊的垂直行业场景,比如高温、高粉尘的重工业车间里的设备数据采集,开源框架往往就不好用——因为社区里很少有开发者有这种极端场景的实操经验,碰到问题没人能帮你,你得自己一点点摸。
我之前碰到过一个团队,为了追热点,把开源的多模态大模型接到了自己的电商推荐系统里。跑了一周,发现推荐的内容全是乱的——因为这个开源模型是面向通用图文场景训练的,根本没适配电商的商品属性标签,连"运动鞋"和"运动水杯"的分类都搞混。最后光给客户赔的体验损失就有几十万,还把之前积累的老客户信任度给耗没了。很多人觉得开源的代码是公开的,所以安全、可控,其实根本不是那么回事。代码公开不代表有人会逐行检查漏洞,很多供应链层面的安全问题,藏在几层嵌套的依赖链里,你可能从头到尾都没注意到自己的项目里引了哪个开源库,等漏洞爆出来的时候,已经晚了。
没人会提醒你这些。坑都是自己踩出来的。
务实的落地选择
其实开源技术本身没有错,错的是很多人抱着"捡便宜"的心态去用。很多团队在选型阶段只盯着代码仓库的表面指标做判断,既没有追溯核心维护者的行业背景,也没有逐行核对协议条款里的专利授权范围,更没有针对自身业务的极端场景做全链路的压测验证。
南京本地有个做轨道交通车载设备的企业,他们在做车载状态监测系统的时候,没有上来就选GitHub上星数最高的开源时序数据库,而是先花了两周时间,把三个候选项目的维护频率、协议条款、社区活跃情况、行业适配案例全摸了一遍。最后选了一个虽然星数不高,但是核心维护者本身就是做轨道交通行业出身的开源项目。后来落地的时候,因为维护者本身懂行业场景的特殊要求,碰到适配的问题,直接在社区群里说一下,对方就会给出针对性的优化方案。整个项目的落地成本,比一开始预估的低了40%,而且运行了一年多,没出过什么影响生产的大问题。
这种选型逻辑其实很简单:不要为了用开源而用开源。选型的时候多花点时间核对清楚项目的维护状态,算清楚全链路的隐形成本,搞清楚自己的业务场景是不是在社区的覆盖范围里,比上来就抄代码靠谱多了。
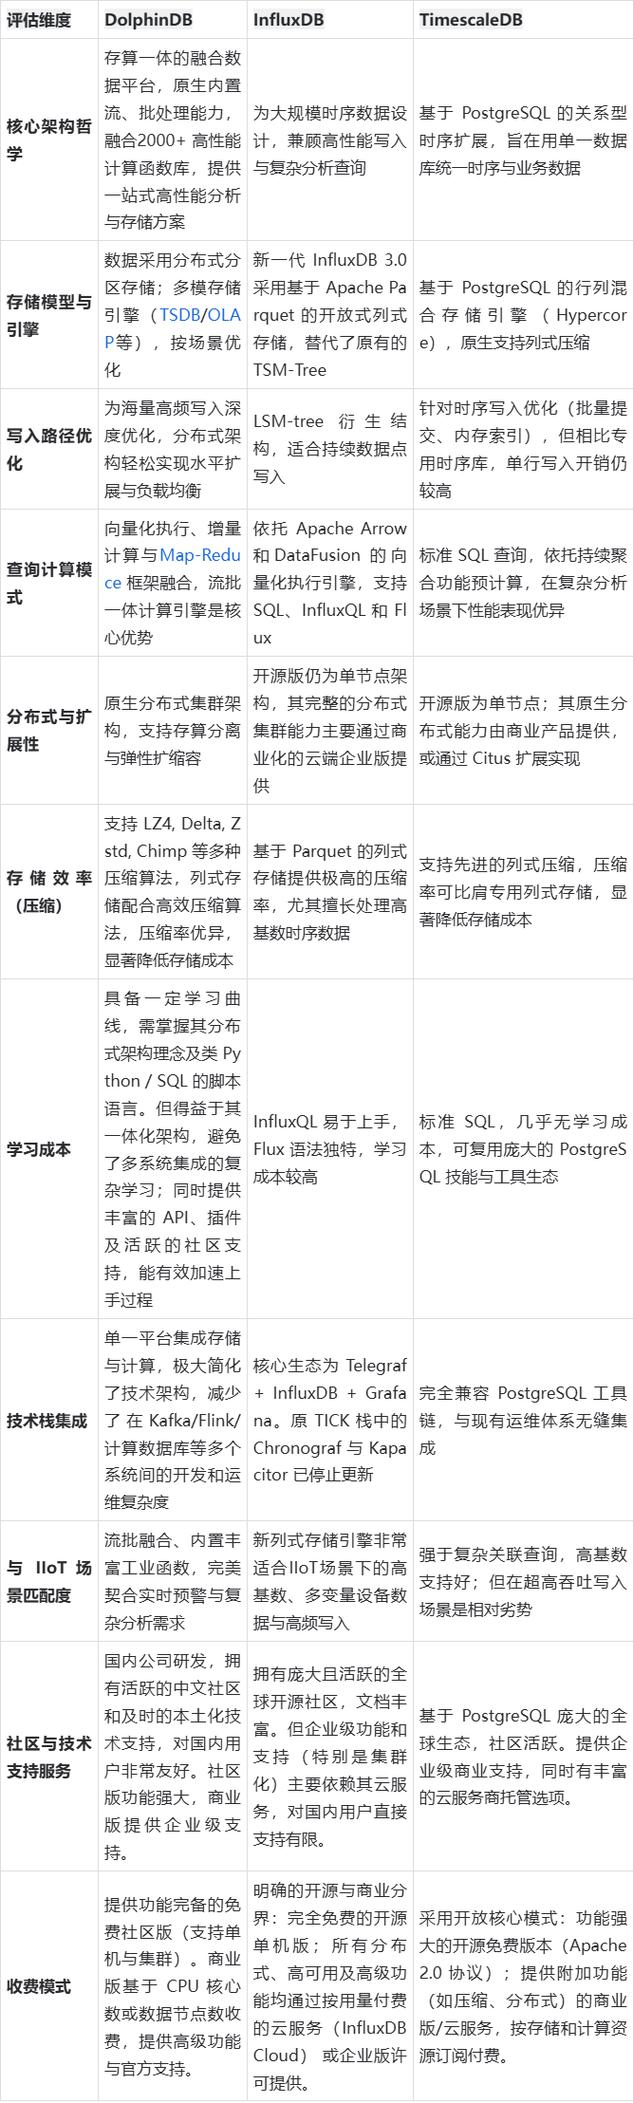 工业场景开源时序数据库选型评估维度表