踩过20个坑之后,我眼里的云计算平台构建到底该怎么做
前阵子帮一个国企朋友搭私有云,三个月掉了快十斤头发。不是技术难,是太多人上来就喊着上K8s,喊着搞全云原生,最后预算超了三倍,跑起来还不如人家小团队搭的裸机稳。
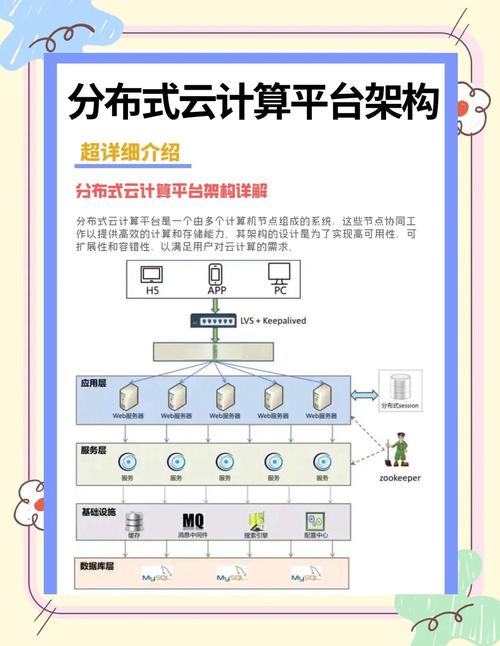 不同业务场景云计算平台构建需求对比表
说实话,现在云计算圈的营销话术太害人,什么“弹性扩容”“秒级调度”全给你堆上来,你得自己拎清楚:你要的是99.99%的核心业务可用性,还是AI训练的极致算力密度,还是数据不出域的合规要求?对吧?
要是做政务云,合规比什么花里胡哨的功能都重要,你非要搞什么跨公网的混合云调度,纯属给自己找事。要是做电商直播的流量平台,峰谷差能差出十几倍,没有自动弹性扩容,大促一来直接全崩,找谁哭去?
一百台节点以下的内部开发云,你非要搞什么多层调度,多可用区容灾,投入产出比算过吗?很多东西,大厂需要不代表你需要,别拿别人的菜谱当自己的做饭指南。
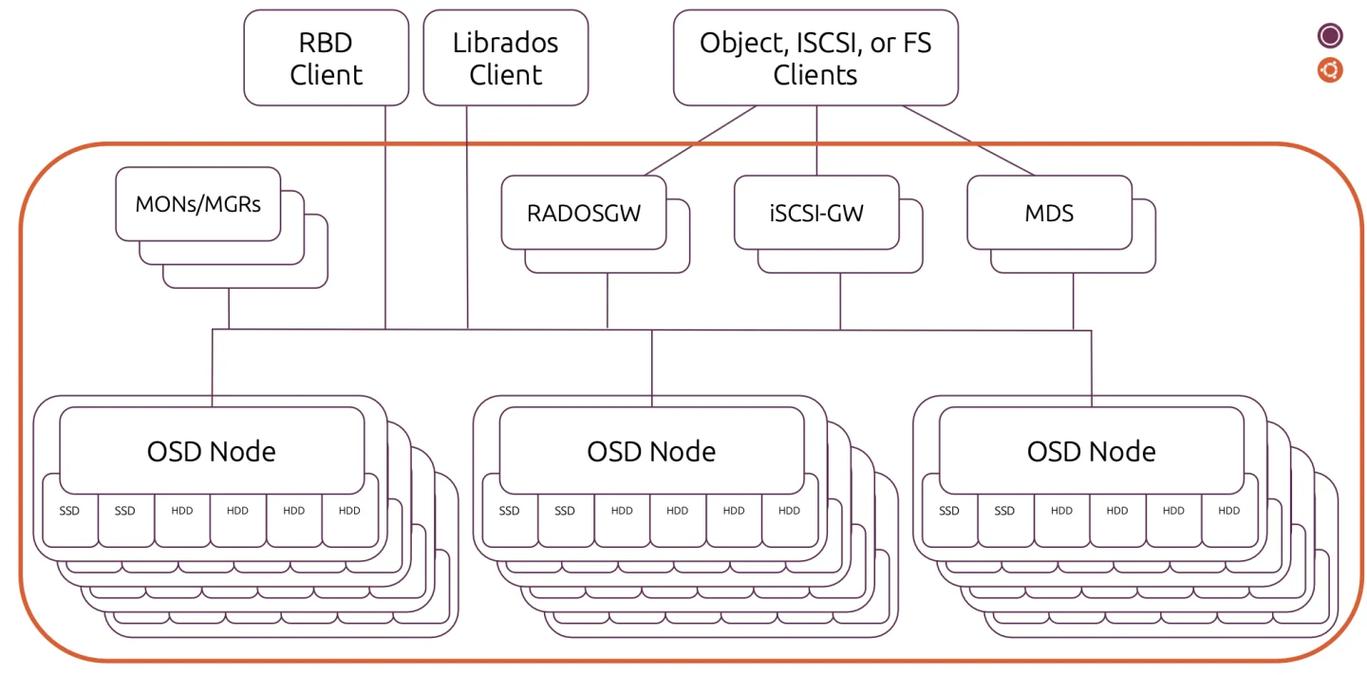 云计算平台CEPH存储架构部署拓扑图
不过话说回来,也不是说开源就一定不好。你要是搭个内部测试用的开发云,几十TB数据,CEPH完全够,稳得很,没必要花大价钱买商业版。核心是匹配你的需求,别死撑面子活受罪。
还有个误区我必须吐槽,现在人人都喊存算分离,好像不搞存算分离就是落后。我就问一句,你一个不到五十台节点的小集群,存算分离的调度开销你算过吗?存算耦合直接本地读盘,效率比存算分离高多了,成本还低一半,绕那个弯干嘛?技术是为业务服务的,不是用来装先进的。
 可观测性不是可选项,是你平台活下去的根本
很多团队搭云计算平台,把所有的预算和精力都花在计算、存储、网络这些硬资源上,上线了才发现监控都没做全,出了问题两眼一抹黑,只能等用户找上门。
上个月还有个朋友找我救急,他们的私有云跑了三个月,某天一台核心计算节点的网卡出了错包,平台愣是没报警,等做直播业务的客户发现推流断了找上门,已经停了四十多分钟,赔偿了小二十万。为什么会这样?因为他们搭建的时候,只监控了CPU和内存使用率,网卡的错包率、存储的IO延迟这些核心指标,根本没做告警规则。
现在的云计算平台,节点少则几十多则上万,全靠人盯根本不可能。你得从构建第一天,就把可观测性埋进去,日志、指标、链路追踪三个东西一个都不能少。别信什么“以后业务跑起来再补”,等平台上线几百个服务跑上去,你再插可观测性,比登天还难,牵一发动全身,稍不注意就把业务弄挂了。
很多人觉得,整个Prometheus整个Grafana就是可观测性了,不对,那只是基础工具。你得针对自己的业务优化告警规则,别一天发几千条无用告警,最后真出问题了,早就被刷没了。我见过最夸张的,一个运维一天收一万多条告警,直接把告警群开了免打扰,真出问题根本看不见。
说白了,云计算平台构建,哪有什么万能银弹?无非就是别跟风装逼,从自己的口袋和需求出发,踩一个坑填一个坑。大厂的架构是大厂堆了几千工程师踩了十几年坑踩出来的,你几十人的团队非要抄人家的架构,那不崩才怪。够用,好用,成本可控,就是好平台。
别上来就堆组件,先搞清楚你的底层需求到底是什么
很多企业启动云计算平台构建项目,第一反应不是梳理需求,而是打开GitHub看现在最火的开源项目是什么,或者问大厂现在卖什么方案最热门。 跟风的结果,就是钱花了一大半,用起来处处别扭。 我去年接触一个做AI大模型微调的创业团队,创始人听了两场发布会,拍板要搭三万核的共享算力集群,上来就先买了二十台GPU服务器,结果预算算错了,连分布式存储的钱都留不出来,最后练个7B参数的模型,读数据卡得要死,不得不把服务器卖了三台换存储,里外里亏了小一百万,进度拖了两个多月。不同业务场景云计算平台构建需求对比表
说实话,现在云计算圈的营销话术太害人,什么“弹性扩容”“秒级调度”全给你堆上来,你得自己拎清楚:你要的是99.99%的核心业务可用性,还是AI训练的极致算力密度,还是数据不出域的合规要求?对吧?
要是做政务云,合规比什么花里胡哨的功能都重要,你非要搞什么跨公网的混合云调度,纯属给自己找事。要是做电商直播的流量平台,峰谷差能差出十几倍,没有自动弹性扩容,大促一来直接全崩,找谁哭去?
一百台节点以下的内部开发云,你非要搞什么多层调度,多可用区容灾,投入产出比算过吗?很多东西,大厂需要不代表你需要,别拿别人的菜谱当自己的做饭指南。
云计算平台构建的核心坑:分布式存储绕不开的坎
我统计过,十个自己搭私有云的团队,七个栽在存储上。计算节点坏了,大不了重启换一个,业务最多切个流量,损失不大。存储要是出问题,那就是真金白银的数据没了,核心业务直接停摆。 很多新手一开始图便宜,拿开源CEPH直接堆,什么调优都不做,跑个十几TB的小业务没问题,数据量超过100TB之后,IO延迟直接翻两三倍,高峰期写个数据要等好几秒,跑核心业务根本顶不住。 今年上半年有个城商行的客户,原来用的未调优的开源CEPH跑核心交易系统,峰值的时候交易延迟直接飙到500ms以上,用户投诉翻了三倍,最后换了专为低延迟优化的NVMeoF分布式存储架构,才把延迟压到20ms以内,前前后后花了大半年才迁移完,浪费了不知道多少人力。云计算平台CEPH存储架构部署拓扑图
不过话说回来,也不是说开源就一定不好。你要是搭个内部测试用的开发云,几十TB数据,CEPH完全够,稳得很,没必要花大价钱买商业版。核心是匹配你的需求,别死撑面子活受罪。
还有个误区我必须吐槽,现在人人都喊存算分离,好像不搞存算分离就是落后。我就问一句,你一个不到五十台节点的小集群,存算分离的调度开销你算过吗?存算耦合直接本地读盘,效率比存算分离高多了,成本还低一半,绕那个弯干嘛?技术是为业务服务的,不是用来装先进的。
可观测性不是可选项,是你平台活下去的根本
可观测性不是可选项,是你平台活下去的根本
很多团队搭云计算平台,把所有的预算和精力都花在计算、存储、网络这些硬资源上,上线了才发现监控都没做全,出了问题两眼一抹黑,只能等用户找上门。
上个月还有个朋友找我救急,他们的私有云跑了三个月,某天一台核心计算节点的网卡出了错包,平台愣是没报警,等做直播业务的客户发现推流断了找上门,已经停了四十多分钟,赔偿了小二十万。为什么会这样?因为他们搭建的时候,只监控了CPU和内存使用率,网卡的错包率、存储的IO延迟这些核心指标,根本没做告警规则。
现在的云计算平台,节点少则几十多则上万,全靠人盯根本不可能。你得从构建第一天,就把可观测性埋进去,日志、指标、链路追踪三个东西一个都不能少。别信什么“以后业务跑起来再补”,等平台上线几百个服务跑上去,你再插可观测性,比登天还难,牵一发动全身,稍不注意就把业务弄挂了。
很多人觉得,整个Prometheus整个Grafana就是可观测性了,不对,那只是基础工具。你得针对自己的业务优化告警规则,别一天发几千条无用告警,最后真出问题了,早就被刷没了。我见过最夸张的,一个运维一天收一万多条告警,直接把告警群开了免打扰,真出问题根本看不见。
说白了,云计算平台构建,哪有什么万能银弹?无非就是别跟风装逼,从自己的口袋和需求出发,踩一个坑填一个坑。大厂的架构是大厂堆了几千工程师踩了十几年坑踩出来的,你几十人的团队非要抄人家的架构,那不崩才怪。够用,好用,成本可控,就是好平台。