科技文献检索:别让你的科研死在找文献这一步
上个月帮一个直博二年级的小朋友改开题报告,翻完他列的参考文献,我血压都上来了。四十篇文献,三十一篇是五年前的中文综述,最新的前沿成果一篇都没找着。
问他怎么搜的,说打开知网输了课题名,翻了前两页就把能下的都下了。
害。
这不叫检索,这叫碰运气。
别再只会翻检索结果的前两页了
很多人读了四年本科,早把检索课上学的东西忘光了吧?觉得布尔逻辑那套是老掉牙的东西,没用。我告诉你,恰恰是这个最基础的东西,能把你的检索效率提高十倍不止。
就拿最常见的课题举例,你做大模型在药物靶点预测中的应用,直接把整句话输进数据库,能出来什么好结果?大部分都是沾点边的垃圾,真正相关的早就埋到几十页之后了。
正确的做法是什么?先拆关键词,把所有同义表述列出来,再用布尔逻辑拼起来。大模型可以是大语言模型、基础模型,药物靶点预测可以叫靶标识别,那拼起来就是:(大模型 OR 大语言模型 OR 基础模型) AND (药物靶点预测 OR 靶标识别)。如果搜出来一堆和医疗保险AI相关的无关内容,直接加个NOT 保险,世界一下子就清净了。
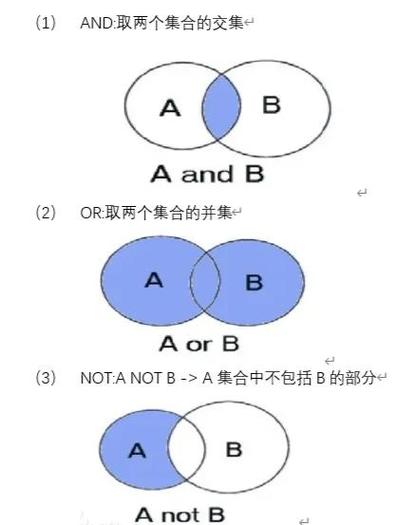 科技文献检索布尔逻辑运算符使用示例图
很多人说我这是小题大做,现在AI这么发达,直接让ChatGPT找文献不行吗?说实话,AI找文献能给你当引子,真要用来做课题,太容易掉坑了。我就碰到过学生拿着GPT编的三篇假文献过来,作者名对,期刊名对,卷期全错,根本找不到原文,差点闹到答辩的时候被评委问住,太尴尬了。
藏在主流数据库之外的检索宝藏
大部分人找文献,就只会去知网、PubMed、谷歌学术这几个,搜完就结束了。其实很多前沿信息,根本不在正式发表的期刊里。
你知道现在领域内大牛做出来新成果,一般先挂哪儿吗?预印本平台。arXiv收数理计算机,bioRxiv收生物医学,很多成果正式见刊,比挂预印本晚半年甚至一年。你不搜预印本,闷头做了半年,做完才发现人家早就做出来了,还是一模一样的结论,那种打击,想想都懊恼。
还有一个工具我吹了好多年,就是Connected Papers。你只要输入一篇领域内的核心文献,它直接给你画出整个领域的文献引用关系网,谁是开创者,哪个分支是最近两年火起来的,哪几篇是绕不开的经典,一眼就能看明白,比你自己瞎梳理省多少事。
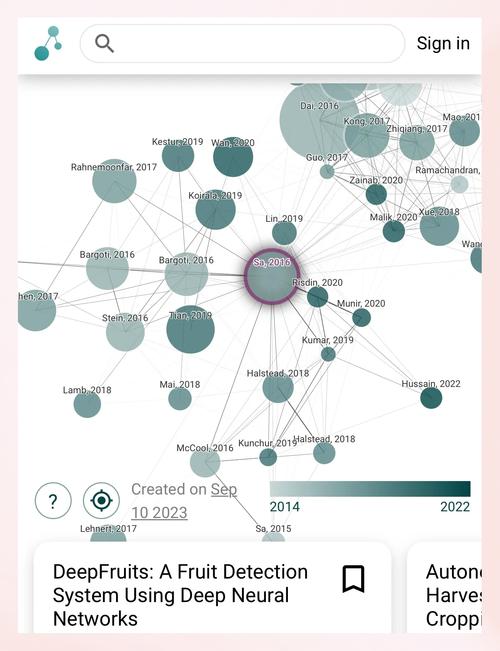 Connected Papers科技领域文献引用关系网络图
哦对了,还有一个冷门技巧,谷歌学术的高级筛选里,有个「在线可用」的选项,勾上之后直接显示能免费下载的文献,不用到处找镜像、到处求别人发全文,太省时间了。
科技文献检索的核心根本不是「找」,是「筛」
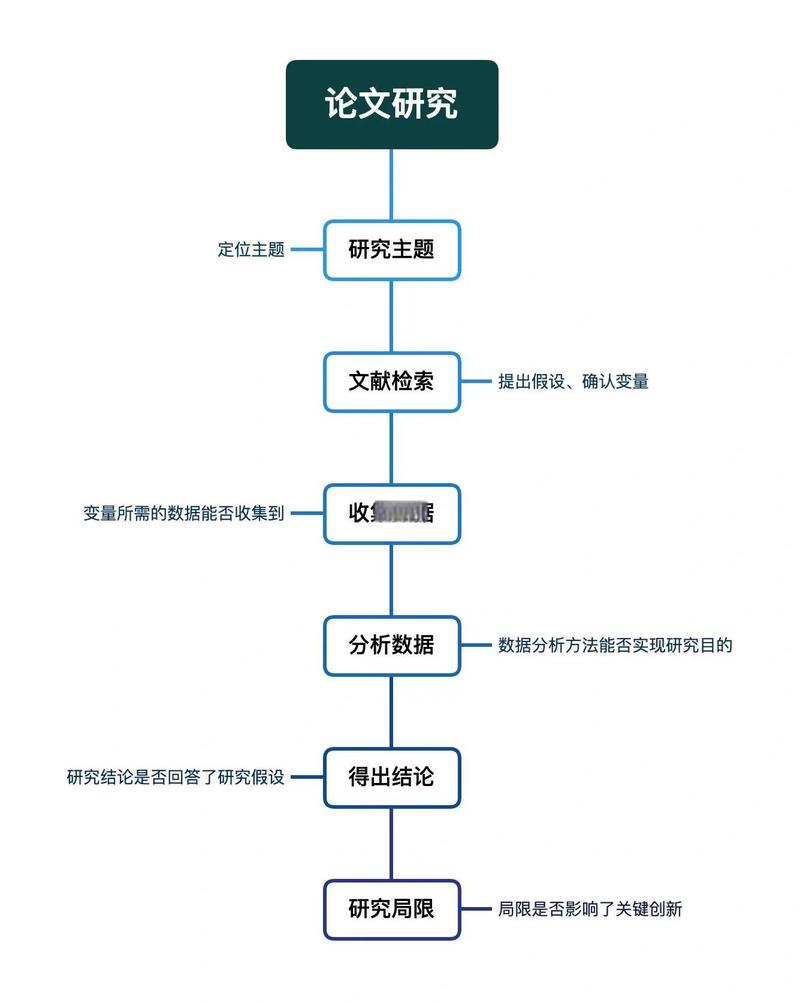 科技文献检索的核心根本不是「找」,是「筛」
现在每年新出的科技文献,得数亿篇吧?就算你是个极小的细分方向,一年也能出个大几百篇,你全读根本读不完。所以检索的本质,就是帮你把没用的垃圾文献都过滤掉,只留下真正值得读的。
我自己用了十几年的方法,就是顺藤摸瓜溯源法:先找一篇近两年发表的领域顶刊综述,把它引用的核心文献全部列出来,顺着这些核心文献,再挖它们引用的经典开创文献,再反过来找最近三年引用这些核心文献的新成果,这么一圈下来,整个领域的来龙去脉就全清楚了,比你瞎输关键词翻一百页都管用。
很多人说,我时间不够,能不能让AI帮我读文献总结?AI总结可以当预习,但核心文献一定要自己读原文。我见过太多AI总结错核心结论,把人家否定的结论说成肯定的,最后整个课题方向都错了,找谁哭去?
不过话说回来,筛文献也有技巧,先看标题摘要,不对直接扔,符合方向的再看图表和结论,真的和你做的东西相关,再留下来精读。这么下来,一百篇检索结果里,留下十篇值得读的就够了,不用什么都抓。
真的,科研这行,从来不是比谁熬的夜多,比谁写的代码长。方向对不对,信息全不全,一开始就决定了一大半。而科技文献检索,就是帮你摸对方向的那根指南针。
多花两天时间把文献找全找对,后面能给你省好几个月的无用功。怎么算都太值了。