智能决策支持:从纸面论文到老板办公桌上的真东西
前几天跟某大厂做供应链的老学长喝酒,他拍着桌子吐槽,说之前花几百万上的“智能决策”系统,最后还不如他干了二十年的老调度拍板准。
骗钱的概念太多了。今天就掰扯清楚,这个被炒上天的智能决策支持,到底是真有用还是割韭菜。
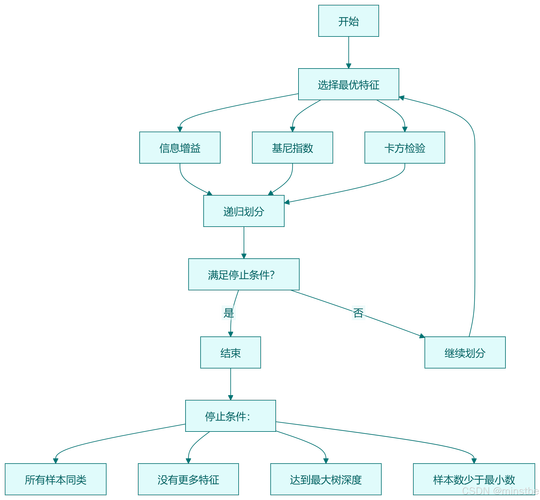 早期智能决策支持系统核心决策流程图
这些年厂商为了卖货,把概念炒变味了。张口就是“全自动决策”“无人化管理”,真落地起来,碰到一点突发情况就掉链子。去年我接触过一个做生鲜连锁的老板,上了所谓的智能订货系统,梅雨天气还按照历史数据给你推两倍的叶菜订货量,烂了十几万的货,最后还是用回了店长经验加工具辅助的路数。
说实话,真正符合科研方向的落地成果,从来都不抢决策者的位置。去年Nature子刊发了哥大与上海交大合作的港口调度研究,成果说穿了很简单:系统不直接调集装箱,只是给调度员算出不同方案下,未来12小时的拥堵概率、滞港成本,推三个容错率最高的选项区间,最后调度员结合实际船期变化选。就这么个设计,比纯人工调度效率提了47%,比纯AI自动调度的错判率降了62%。
看见没?这才是对的路数。
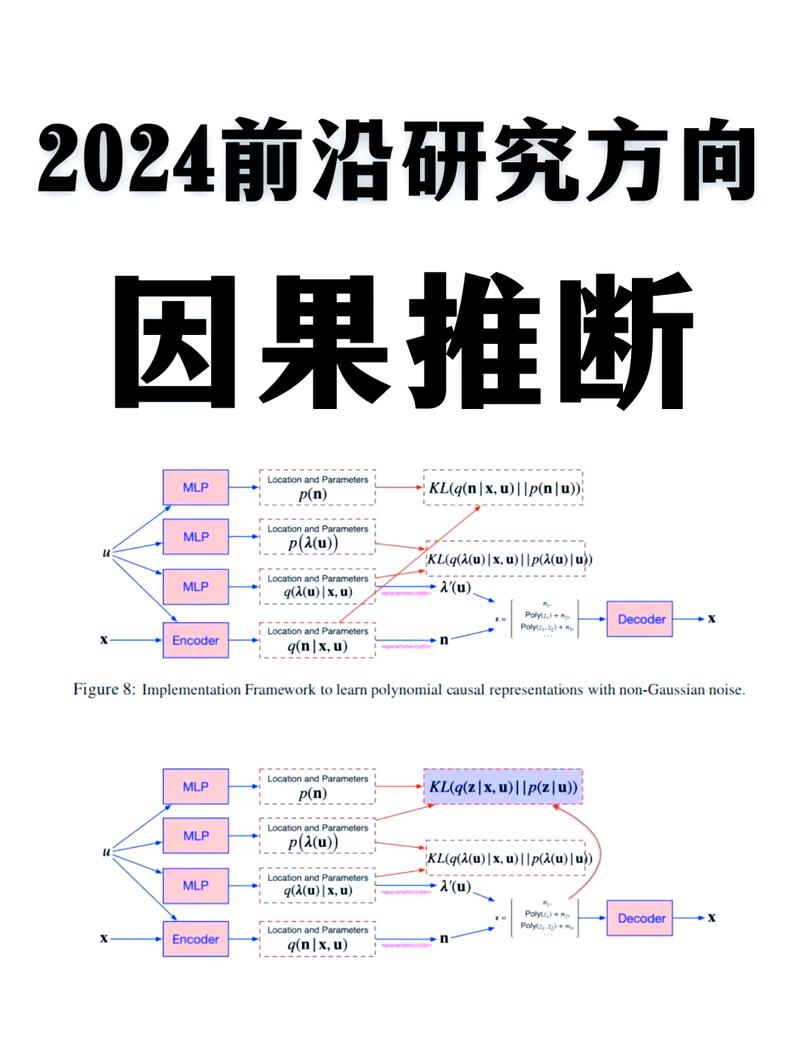 小样本因果推断智能决策支持模型架构图
第二个突破我觉得更接地气,就是匹配决策者偏好的动态调整机制。原来的模型都是死的,上来就给你推一个“全局最优解”,完全不管用这个方案的人是什么风格。保守型的老板觉得最优解风险太大不敢选,激进型的老板觉得最优解太保守赚不到钱,最后方案只能压箱底。
现在最新的模型会先“摸脾气”,跟决策者做几次交互,摸清楚你的风险承受阈值、决策习惯,再推对应风格的备选方案。今年阿里云和中科大合作做的新能源电站调度决策系统,就是这么设计的,不同场站负责人的风格不一样,推的方案就不一样,落地使用率比旧系统翻了一倍还多。
不过话说回来,现在这些突破大部分还停留在实验室和头部企业试点阶段,普通中小企业还很难直接用到成熟的产品,这个是事实。
 普通企业要蹭红利,别上来就砸大价钱
我见过太多企业,一听到新概念就头脑发热,砸个几百万上千万上整套系统,最后用不起来,钱打了水漂。
智能决策支持这波红利,不是只有头部企业能蹭,中小企业也能吃得到,但方法要对。
首先,别搞什么“全链路智能化”,先拆小问题。你是开连锁的,先从每个门店的补货决策下手,你是做加工的,先从原材料采购决策下手,问题拆得越小,投入越低,见效越快,试错成本也低。浙江有个做中小批量服装代工的厂子,去年跟浙大计算机系的科研团队合作,只做了一个面料采购的决策支持工具,花了不到二十万,今年原材料价格波动这么大,他们的库存积压成本直接降了18%,赚回来的钱是投入的五六倍。
其次,别迷信大厂的标准化产品。大厂的产品都是给超大规模企业设计的,你个几十亿规模的企业上去用,很多功能都是多余的,还贵得要死。现在很多高校和科研院所的团队都在找落地场景,定制一个针对你具体问题的小工具,比买百万级的套装划算太多。
最后记住,永远别把拍板权全交出去。真出了问题,机器不会给你背锅,最后挨骂赔钱的还是你自己。智能决策支持最大的用处,就是帮你省掉找数据、算概率、排可能性这些破事,让你把精力放在判断方向、把控风险上,这才是它真正的价值。
再过三五年你再看,它根本不是什么遥不可及的黑科技,就会变成像Excel一样,每个管理者办公桌上必备的工具。帮你少错选几次,就够了。
别被概念忽悠,智能决策支持根本不是“AI替你拍板”
很多人一听名字,就觉得是机器帮你做决定。错得离谱。 早在上世纪70年代,西蒙那批决策理论奠基人就把定义写死了:核心是支持,不是替代。说白了,就是帮你把乱七八糟的信息理清楚,把错选项都删掉,把每个选项的后果摆出来,最后拿主意的还是你。早期智能决策支持系统核心决策流程图
这些年厂商为了卖货,把概念炒变味了。张口就是“全自动决策”“无人化管理”,真落地起来,碰到一点突发情况就掉链子。去年我接触过一个做生鲜连锁的老板,上了所谓的智能订货系统,梅雨天气还按照历史数据给你推两倍的叶菜订货量,烂了十几万的货,最后还是用回了店长经验加工具辅助的路数。
说实话,真正符合科研方向的落地成果,从来都不抢决策者的位置。去年Nature子刊发了哥大与上海交大合作的港口调度研究,成果说穿了很简单:系统不直接调集装箱,只是给调度员算出不同方案下,未来12小时的拥堵概率、滞港成本,推三个容错率最高的选项区间,最后调度员结合实际船期变化选。就这么个设计,比纯人工调度效率提了47%,比纯AI自动调度的错判率降了62%。
看见没?这才是对的路数。
近年的科研突破,都砸在了最疼的那个点上
过去十年,智能决策支持一直迈不过去的坎是什么? 就是没数据的时候,啥也干不了。 你看现在大部分成熟的模型,都要求你有十几年的完整历史数据,才能跑出准确率。可国内百分之八十的实体企业,别说十年数据,能把三年的生产、销售数据理清楚就不错了。碰到原材料涨价、疫情这种突发黑天鹅,原来的训练数据直接作废,模型直接躺平。 这两年最新的科研突破,刚好就打在这个痛点上。第一个就是小样本因果推断型智能决策支持,不需要你堆海量数据,只要三五个同类型的案例,就能通过因果图推导出不同决策的潜在影响。我上个月看清华经管数据科学研究中心发的最新成果,这套方法比传统统计模型的准确率高了34%,对于中小制造、零售这类数据不全的行业太友好了。小样本因果推断智能决策支持模型架构图
第二个突破我觉得更接地气,就是匹配决策者偏好的动态调整机制。原来的模型都是死的,上来就给你推一个“全局最优解”,完全不管用这个方案的人是什么风格。保守型的老板觉得最优解风险太大不敢选,激进型的老板觉得最优解太保守赚不到钱,最后方案只能压箱底。
现在最新的模型会先“摸脾气”,跟决策者做几次交互,摸清楚你的风险承受阈值、决策习惯,再推对应风格的备选方案。今年阿里云和中科大合作做的新能源电站调度决策系统,就是这么设计的,不同场站负责人的风格不一样,推的方案就不一样,落地使用率比旧系统翻了一倍还多。
不过话说回来,现在这些突破大部分还停留在实验室和头部企业试点阶段,普通中小企业还很难直接用到成熟的产品,这个是事实。
普通企业要蹭红利,别上来就砸大价钱
普通企业要蹭红利,别上来就砸大价钱
我见过太多企业,一听到新概念就头脑发热,砸个几百万上千万上整套系统,最后用不起来,钱打了水漂。
智能决策支持这波红利,不是只有头部企业能蹭,中小企业也能吃得到,但方法要对。
首先,别搞什么“全链路智能化”,先拆小问题。你是开连锁的,先从每个门店的补货决策下手,你是做加工的,先从原材料采购决策下手,问题拆得越小,投入越低,见效越快,试错成本也低。浙江有个做中小批量服装代工的厂子,去年跟浙大计算机系的科研团队合作,只做了一个面料采购的决策支持工具,花了不到二十万,今年原材料价格波动这么大,他们的库存积压成本直接降了18%,赚回来的钱是投入的五六倍。
其次,别迷信大厂的标准化产品。大厂的产品都是给超大规模企业设计的,你个几十亿规模的企业上去用,很多功能都是多余的,还贵得要死。现在很多高校和科研院所的团队都在找落地场景,定制一个针对你具体问题的小工具,比买百万级的套装划算太多。
最后记住,永远别把拍板权全交出去。真出了问题,机器不会给你背锅,最后挨骂赔钱的还是你自己。智能决策支持最大的用处,就是帮你省掉找数据、算概率、排可能性这些破事,让你把精力放在判断方向、把控风险上,这才是它真正的价值。
再过三五年你再看,它根本不是什么遥不可及的黑科技,就会变成像Excel一样,每个管理者办公桌上必备的工具。帮你少错选几次,就够了。