系统可靠性设计:别等崩了才想起补窟窿
上个月帮一个创业公司处理故障。核心系统半夜炸了,运维爬起来折腾三个小时才恢复,第二天一算账,丢了快十分之一的付费用户。
心疼吧?
很多人提起系统可靠性设计,第一反应就是加机器堆备份,说白了就是钱多就能搞定。其实根本不是这么回事。
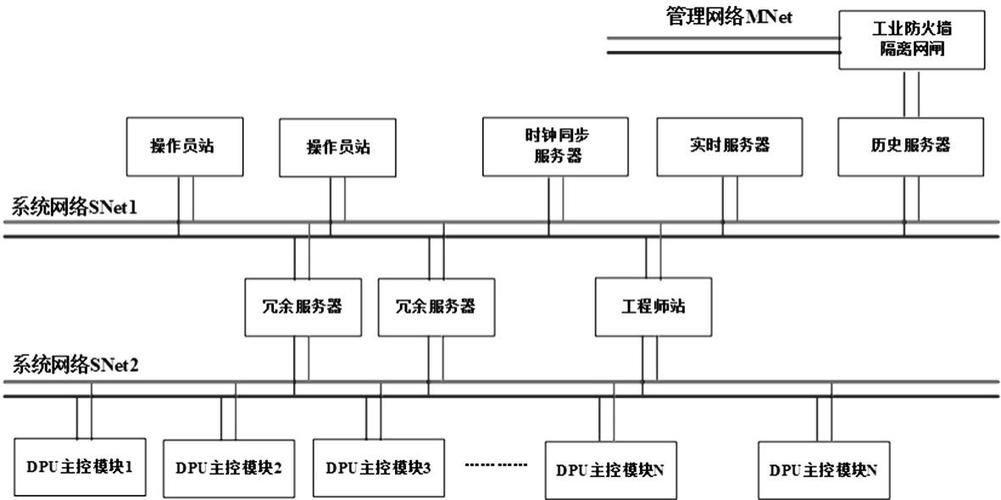 分布式系统主备冗余故障案例示意图
冗余本身不是错,错的是你把冗余直接等同于可靠性。很多人做冗余,就是扔个备机在那儿放着,半年不跑一次切换演练,网络策略都没更,主节点崩了你切过去,备节点连数据库都连不上,有什么用?
还有更夸张的,为了省成本,备节点的配置比主节点砍一半,真切过去,流量一冲直接一起崩,典型的陪死。
系统可靠性设计的第一步,从来不是堆资源,是想清楚你这个系统到底能接受多长时间的不可用,到底哪些部分绝对不能死。
比如电商的支付系统,几秒钟的不可用可能就是几十万的损失,偏门的内部后台报表系统,停两个小时都没人在意,你给报表系统做五地多活不是钱多烧的是什么?
先分层,再做可靠性,这是最基本的逻辑,可惜八成的团队都搞反了。
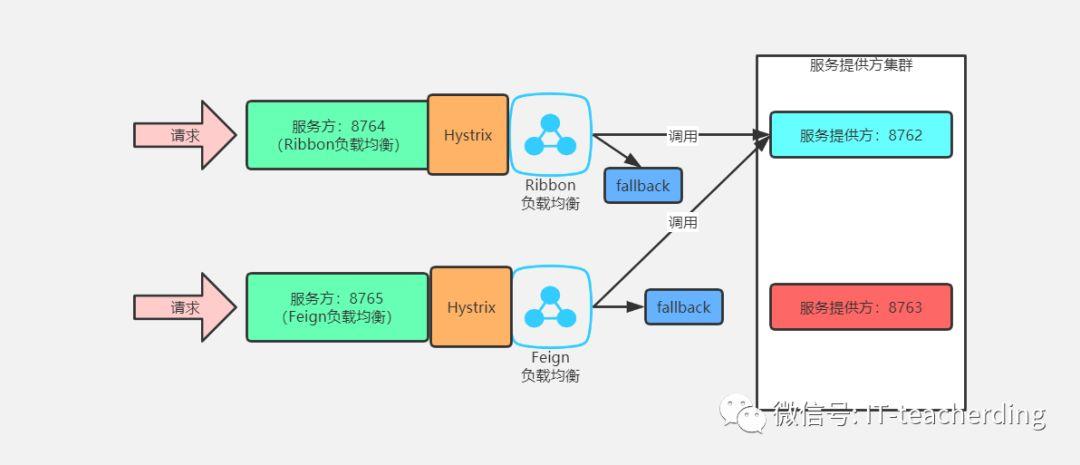 微服务架构熔断降级工作流程图
你刷电商App,推荐服务崩了,不给你推个性化商品就是了,直接放默认的热销商品列表,整个App照样能用,不会整个卡死。这比为了等推荐接口返回,把整个请求挂住强一万倍。
不过话说回来,很多小公司觉得容错是大厂才玩的东西,小项目没必要?不对,哪怕是几个人的小项目,你也能做。
比如你写一个调用第三方短信接口的功能,第三方超时了怎么办?别死等,先给用户返回注册成功,后台慢慢重试,别让用户卡在那儿刷新十几分钟,这就是最简单的容错设计啊。
很多人就是想不透这个,非要死磕一定要拿到正确结果,最后把自己的服务也拖垮,雪崩的时候,没有一个节点是无辜的。
现在流行的混沌工程,说白了就是把这个思路摆到台面上:故意往系统里扔故障,炸几个节点断几个网络,就是为了提前试错,接受系统一定会出错这个事实,才能真的让系统可靠。比天天烧香拜佛求系统别崩强多了。
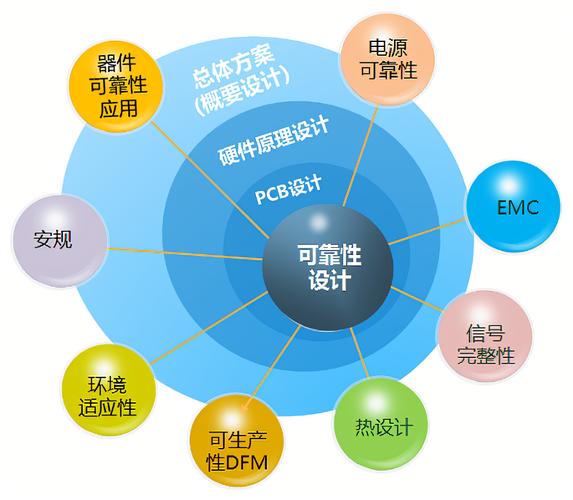 可观测性才是可靠性设计的最后一块拼图
很多团队把冗余、容错都做了,就觉得万事大吉,可以喝酒庆功了。漏了最关键的一步:出了问题你得第一时间知道啊。
我之前碰到过一个案例,一个系统跑了大半年,有个节点的磁盘早就坏了一块,因为做了RAID所以系统没崩,但是没人发现,后来第二块也坏了,整个节点直接挂,历史数据丢了一半,负责人哭都哭不出来。
没有可观测性的可靠性设计,就是瞎子摸象。
什么是可观测性?不是说你只堆几个监控阈值,磁盘使用率超过80%报警就完了。你得能顺着用户的请求一路追下去,用户说我支付失败了,你得一秒钟知道是到银行接口那步错了,还是你自己的订单库锁表了,不是让你翻好几个小时日志,最后还找不到问题在哪。
去年我帮朋友捋一个创业项目的可观测,他们之前把不同服务的日志存在不同服务器上,出问题要一个个登上去查,我们花了三天把日志集中,加了基础的链路追踪,后来出了一次缓存击穿的问题,运维五分钟就定位到问题解决了,换之前最少两个小时起。
这差距,就是真金白银啊。系统不可能永远不出错,出了错你十分钟恢复,和你十个小时恢复,用户的感受和最终的损失,天差地别。
现在大模型火了,一堆创业公司抢着上线大模型服务,上来就先堆GPU卡,满脑子想的是怎么把推理 latency 降下来,根本没人提前做可靠性设计,上个月就听朋友说,好几个新项目上线第一天,流量一冲直接全崩,好不容易拉来的测试用户,转天就全跑了。
说穿了,系统可靠性设计从来不是给专家看的花架子,是真真切切帮你保住用户、保住收入的东西。
偏要等系统崩了,用户走了,才拍脑袋说「哦原来我们该好好做可靠性」,那可不就晚了。
别把「冗余」当万能解药,很多误解从这儿开始
很多人一提到可靠性,第一反应就是做冗余,主节点崩了切备节点,对吧? 说实话,备节点平时躺平,真出问题切不过去的案例我见过没有十次也有八次。去年某头部公有云不还出了故障,跨可用区冗余没生效,整个区域服务停了快四个小时,一堆企业跟着遭殃。分布式系统主备冗余故障案例示意图
冗余本身不是错,错的是你把冗余直接等同于可靠性。很多人做冗余,就是扔个备机在那儿放着,半年不跑一次切换演练,网络策略都没更,主节点崩了你切过去,备节点连数据库都连不上,有什么用?
还有更夸张的,为了省成本,备节点的配置比主节点砍一半,真切过去,流量一冲直接一起崩,典型的陪死。
系统可靠性设计的第一步,从来不是堆资源,是想清楚你这个系统到底能接受多长时间的不可用,到底哪些部分绝对不能死。
比如电商的支付系统,几秒钟的不可用可能就是几十万的损失,偏门的内部后台报表系统,停两个小时都没人在意,你给报表系统做五地多活不是钱多烧的是什么?
先分层,再做可靠性,这是最基本的逻辑,可惜八成的团队都搞反了。
容错的核心是「接受出错」,而不是杜绝所有出错
我之前看过一个刚工作两年的架构师做的设计,为了防止某一个模块出问题,加了十几层校验,环环相扣,最后整个系统的延迟翻了三倍,还只要一处逻辑变了,十几层都要改。 这就是完全走歪了。 世界上根本不存在永远不出错的系统。你就算把所有硬件都做双份,还能碰到光纤被挖断、机房停电这种事,对不对? 现在成熟团队的玩法,都是允许局部出错,绝对不让错误扩散。这才是容错设计的核心。微服务架构熔断降级工作流程图
你刷电商App,推荐服务崩了,不给你推个性化商品就是了,直接放默认的热销商品列表,整个App照样能用,不会整个卡死。这比为了等推荐接口返回,把整个请求挂住强一万倍。
不过话说回来,很多小公司觉得容错是大厂才玩的东西,小项目没必要?不对,哪怕是几个人的小项目,你也能做。
比如你写一个调用第三方短信接口的功能,第三方超时了怎么办?别死等,先给用户返回注册成功,后台慢慢重试,别让用户卡在那儿刷新十几分钟,这就是最简单的容错设计啊。
很多人就是想不透这个,非要死磕一定要拿到正确结果,最后把自己的服务也拖垮,雪崩的时候,没有一个节点是无辜的。
现在流行的混沌工程,说白了就是把这个思路摆到台面上:故意往系统里扔故障,炸几个节点断几个网络,就是为了提前试错,接受系统一定会出错这个事实,才能真的让系统可靠。比天天烧香拜佛求系统别崩强多了。
可观测性才是可靠性设计的最后一块拼图
可观测性才是可靠性设计的最后一块拼图
很多团队把冗余、容错都做了,就觉得万事大吉,可以喝酒庆功了。漏了最关键的一步:出了问题你得第一时间知道啊。
我之前碰到过一个案例,一个系统跑了大半年,有个节点的磁盘早就坏了一块,因为做了RAID所以系统没崩,但是没人发现,后来第二块也坏了,整个节点直接挂,历史数据丢了一半,负责人哭都哭不出来。
没有可观测性的可靠性设计,就是瞎子摸象。
什么是可观测性?不是说你只堆几个监控阈值,磁盘使用率超过80%报警就完了。你得能顺着用户的请求一路追下去,用户说我支付失败了,你得一秒钟知道是到银行接口那步错了,还是你自己的订单库锁表了,不是让你翻好几个小时日志,最后还找不到问题在哪。
去年我帮朋友捋一个创业项目的可观测,他们之前把不同服务的日志存在不同服务器上,出问题要一个个登上去查,我们花了三天把日志集中,加了基础的链路追踪,后来出了一次缓存击穿的问题,运维五分钟就定位到问题解决了,换之前最少两个小时起。
这差距,就是真金白银啊。系统不可能永远不出错,出了错你十分钟恢复,和你十个小时恢复,用户的感受和最终的损失,天差地别。
现在大模型火了,一堆创业公司抢着上线大模型服务,上来就先堆GPU卡,满脑子想的是怎么把推理 latency 降下来,根本没人提前做可靠性设计,上个月就听朋友说,好几个新项目上线第一天,流量一冲直接全崩,好不容易拉来的测试用户,转天就全跑了。
说穿了,系统可靠性设计从来不是给专家看的花架子,是真真切切帮你保住用户、保住收入的东西。
偏要等系统崩了,用户走了,才拍脑袋说「哦原来我们该好好做可靠性」,那可不就晚了。