专利信息分析:别被那些华丽的统计图表忽悠了
做了这么多年专利信息分析,我最大的感受就是:废话太多,真话太少。不是我不想说,是市面上大多数分析报告真的没法看。今天咱们不聊那些虚头巴脑的宏观趋势,就扒一扒专利分析里那些真实得不能再真实的坑。
先给各位看个现象。某行业联盟发了一份年度专利报告,密密麻麻的折线图,说某某领域申请量五年涨了十倍,看着是挺振奋人心。可你仔细翻翻原始数据,好家伙,里面塞了大量外观设计专利和实用新型,还有一堆已经失效的申请。这分析有个毛线用?那些数值,充其量是给外行人看个热闹。
专利信息分析到底在分析什么
有人以为专利分析就是画画统计图表,搞个申请量排名、发明人排名。说实话,我见过太多这样的“报告”,一页页的柱状图,然后得出一个“某企业技术实力最强”的结论……你问这有什么用?人家技术实力强弱,跟你有半毛钱关系?
真正的专利信息分析,是拆解专利背后的情报。一件专利,从申请到公开,从审查到授权,再到后续的无效、诉讼,每一个环节都在传递信号。我们分析的是技术路线、法律边界和市场布局。比如,某个竞争对手突然在某个冷门IPC分类号下疯狂申请专利,又或者开始大量提交PCT申请——这时候你就该警惕了,人家可能在悄悄布局一个新的技术方向。
这里再强调一点:专利信息分析的核心,是构建一个能回答问题的框架。问题不同,方法就不同。想了解技术发展趋势,可以做趋势分析;想摸清竞争对手的底牌,可以做申请人分析;想看技术空隙,就得做技术功效矩阵。
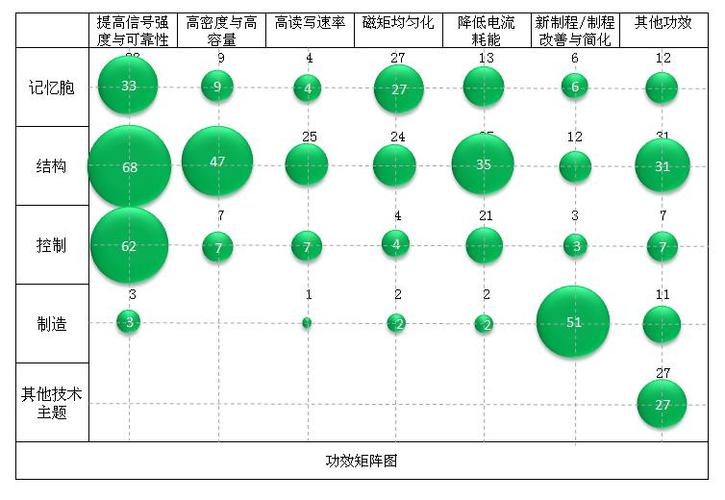 专利分析技术功效矩阵图示例
这种矩阵图,横轴是技术手段,纵轴是技术效果,一眼就能看出哪个格子是空白,哪个格子挤满了人。抓到了空白区,你的研发方向自然就清晰了。我每次给科研团队讲课时都喜欢用这个例子:没有目标的分析,等于捡了芝麻丢了西瓜。
那些年我们踩过的专利数据坑
 那些年我们踩过的专利数据坑
我要是把所有踩过的坑列出来,够写一本书了。今天挑几个最要命的说说。
第一个坑,申请人名称混乱。同一家公司,中英文、全称简称、还有并购前的旧名称,数据库里能给你拆成一堆“马甲”。你拿原始数据直接统计,妥妥地失真。比如之前的某大国企,改名改制后,新申请用的是新名字,旧专利还在旧名字下,你要是不做数据清洗,就把人家资产活活砍了一半。所以,我每次做分析,第一步永远是清洗申请人名称,别名合并,再下结论。这一步省不得。
第二个坑,同族专利和专利族的区别。很多人搞不清楚,一家公司在全世界几十个国家申请同一件发明,这是一个专利族。如果你直接数申请件数,会发现一个技术方案重复计算了几十次。正确的做法是按INPADOC或者简单同族去重。可现实中,我见过有报告把同族的每一件都当成独立专利,结果全球top10申请人排名全是国际巨头,有意思吗?没意思。
第三个坑,法律状态信息滞后。专利数据库里反映“有效”的专利,可能已经因为未缴费而失效好几个月了。你要拿来分析“有效专利”的布局,不踩雷才怪。最好是交叉核对最新的法律状态,或者直接采用官方登记簿的数据。
第四个坑,引证数据缺失。专利引证分析是判断技术脉络的利器,但很多数据库的引证数据本身就残缺不全,尤其是早期的专利和部分国家的数据。你拿一个残缺的引证网络去画技术路线图,很容易把一个边缘的小角色看成核心节点。所以,做引证分析前,最好先确认一下数据来源的覆盖率,别被背后的“黑洞”带偏了。
这些都是血泪教训啊。数据清洗、数据加工这些脏活累活,看似没技术含量,恰恰是专利分析的地基。地基打不牢,上面盖多高的楼都得塌。
科研项目里,专利信息分析还真不是充门面
有人说,专利分析不就是给科研项目做个陪衬吗?写本子的时候,加上一张专利态势图,显得自己做过功课。说实话,以前我也这么觉得,直到有一次被现实狠狠打脸。
前两年,我们配合某高校研究团队做钙钛矿太阳能电池的选题评估。课题组的初步设想,是往钙钛矿界面优化方向冲,觉得有创新。结果我们把全球专利信息拉出来,做了个引证分析和技术路线图,发现这个方向上,某国外巨头已经布置了几百件专利,关键结构被层层围死。再往里走,大概率是给人家做专利陪跑。不过我们又看到他们的专利布局里,特意避开了一个特殊的溶剂添加剂。于是建议课题组往这个细分方向主攻。后来的结果,项目顺利通过评审,还拿了重点基金。这事给我带来的震撼挺大的——原来专利分析真的能指路。
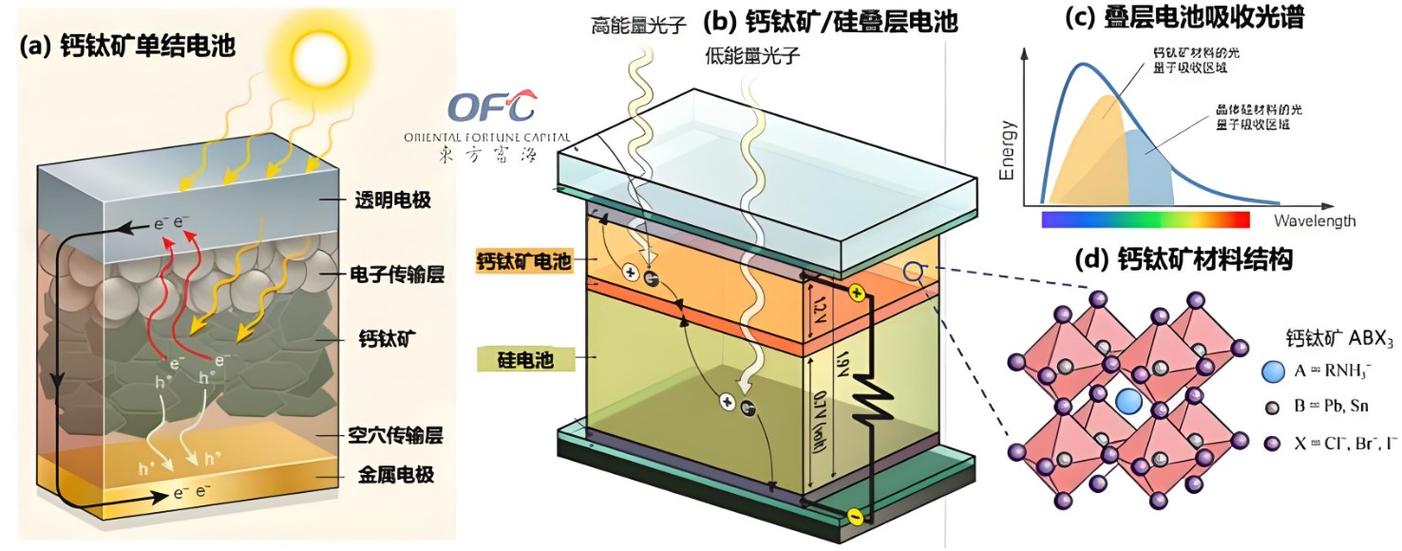 钙钛矿太阳能电池专利技术地图图谱
老实说,这种技术地图并不神秘,只要你会用专利分析工具,再花点耐心去看核心专利的引用关系,就能画出来。难点不在于工具,而在于你能不能忍住不加班,沉下心去读那几百条专利权利要求。
当时我们具体怎么做的呢?先把检索式做出来,用国际专利分类和关键词组合,再按时间切片,把近五年的申请都下载下来。然后重点看同族的合并,再用引用关系排序,找出那些被引次数特别高的“关键专利”。这活儿枯燥,但收获大。后来,我们还用了一个开源的文本聚类工具,把那些专利摘要聚成了几簇,一眼就看出哪个方向是无人区。整套流程下来,也就两周时间,但给课题组省下的经费和精力,远超这些时间成本。仔细想想,挺值的。
所以,科研人员与其拍脑袋定方向,不如先花几天时间做一次系统的专利信息分析。不是为了应付评审,是让你自己心里有底。同样的钱、同样的时间,是冲进红海里跟巨头血拼,还是找一片蓝海撒网,就看这个分析做得够不够到位了。
写到最后,我想说,专利信息分析这门手艺,看着入门容易,精通难。市面上那些花里胡哨的报告,很多都是糊弄人的。下次你再看到一份专利分析报告,别急着点赞,先问一句:你的数据源是什么?清洗过吗?如果您能回答上来,那才算没有白看这份报告。