技术成果评估:别再让专家拍脑袋了
上个月,我被拉去评一个项目。说是‘颠覆性技术’,PPT做得天花乱坠。结果呢?我看了三天资料,愣是没看出哪里颠覆了。可其他专家都打了高分——因为牵头的是个大牛。我那个憋屈啊。
说实话,这种事儿我遇过不止一次。技术成果评估,本该是个严肃活儿,硬生生搞成了人情分、名气分、甚至‘谁和我关系好谁分高’的游戏。我有时候真想摔笔走人,但一想,走了又能怎样?换一拨人,还是同样的剧本。
所以今天想聊聊这个事儿,不扯什么高大上的理论,就说点大实话。
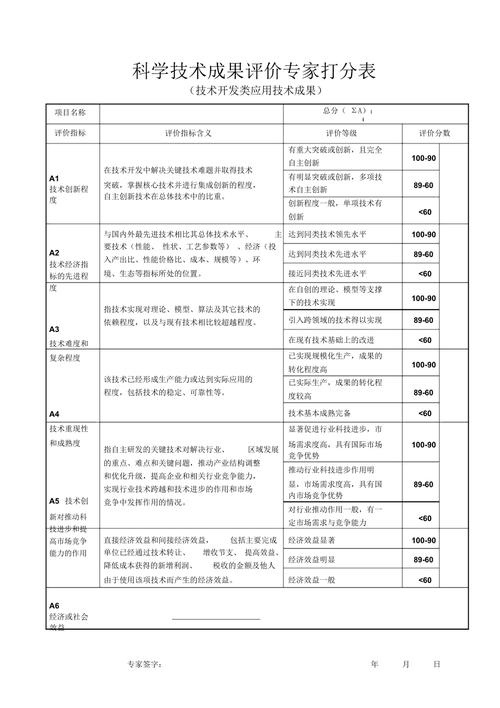 科技成果专家评分纸质表格
更头疼的是,那些写着‘国际领先’‘填补空白’的成果,到底怎么验证?有一次我较真,让项目方拿出第三方检测报告,结果对方支支吾吾,最后憋出一句‘我们正在联系’。得,又是一个空头支票。但评委会里没人追问,大家都心照不宣地给了‘优秀’——因为会前打过招呼了。这种评估,评的不是技术,是人际。
我有时候就想,这评分表上的灰尘,是不是该掸一掸了?
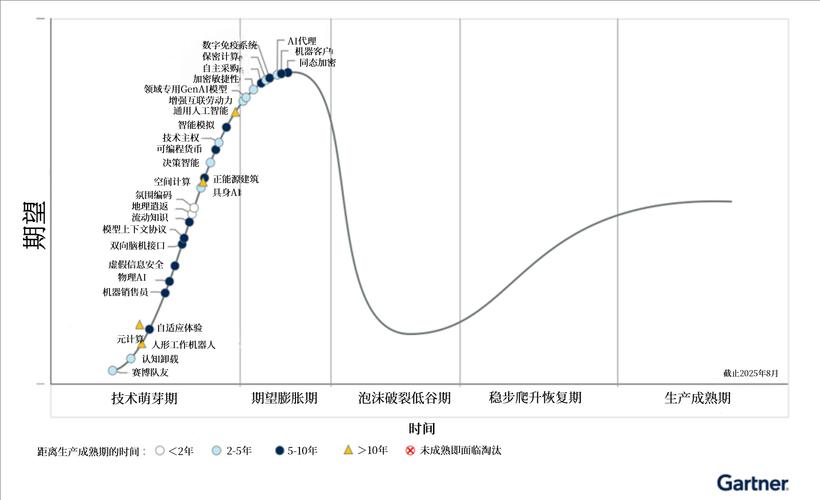 技术成熟度曲线九个等级示意图
所以数据靠得住,前提是你得知道它怎么来的。但评估专家哪有时间深挖?半天审一个项目,材料摞起来半人高,最后只能看摘要。说到底,还是信任问题——你信不信这个团队的人品和能力。可人品这东西,怎么评?
更魔幻的是,有些评估模型复杂得要命,又是层次分析又是模糊综合,最后得出一个精确到小数点后两位的分数。看起来科学极了,但底层的输入数据还是主观打分。这不就是传说中的‘垃圾进、垃圾出’吗?我有时候觉得,我们花了太多精力折腾评估方法,却忘了最根本的东西:这个技术,到底能不能解决问题?
评分表上的灰尘
传统的评估,就是几张表。先进性、创新性、实用性……每个维度打几分,最后加权一算,搞定。可这玩意儿,大部分时候是凭感觉。你让一个搞理论物理的专家去评一个应用工程的成果,他能懂多少?他只能看专利数、论文数,但这些数字,真的能代表技术的价值吗?我见过一个团队,发了上百篇SCI,但产品一量产就歇菜——工艺不过关,成本下不来。可评分表上,他们永远是高分。科技成果专家评分纸质表格
更头疼的是,那些写着‘国际领先’‘填补空白’的成果,到底怎么验证?有一次我较真,让项目方拿出第三方检测报告,结果对方支支吾吾,最后憋出一句‘我们正在联系’。得,又是一个空头支票。但评委会里没人追问,大家都心照不宣地给了‘优秀’——因为会前打过招呼了。这种评估,评的不是技术,是人际。
我有时候就想,这评分表上的灰尘,是不是该掸一掸了?
到底什么叫‘好’成果?
这个问题,我估计十个专家有九个半说不清。是技术参数越高越好?还是市场卖得越火越好?我见过一个做新材料的中小企业,参数一般,但成本极低,下游抢着用。按传统标准,它连‘先进’都够不上,但它活下来了,还赚了钱。你能说它不是好成果? 反观某些院所,拿着国家几千万的经费,搞出个‘世界首例’,但永远锁在实验室里,转化率为零。这种成果,除了评奖和评职称有用,对社会有什么价值?可我们的评估体系,偏偏更青睐后者。 我理解,基础研究不能全看经济价值,但你也别拿‘科学意义’当万能挡箭牌啊。有些成果,说白了就是自娱自乐,甚至连科学同行都懒得引用。这时候还硬说它‘重大’,就有点自欺欺人了。 所以,‘好’应该是一个多维度的东西。技术就绪度、商业可行性、团队执行力、甚至政策风险……这些都得看。但把这些揉在一起,又不失客观,太难了。数据不会说谎,但人会
现在很多评估开始引入定量指标。比如引用次数、专利转化率、市场占有率。这比拍脑袋强,但还是有坑。引用可以互刷,专利可以凑数,市场数据也能注水。我见过一个项目,号称产品已经出口十几个国家,结果一查,全是些皮包公司过了一手,根本没到终端用户。技术成熟度曲线九个等级示意图
所以数据靠得住,前提是你得知道它怎么来的。但评估专家哪有时间深挖?半天审一个项目,材料摞起来半人高,最后只能看摘要。说到底,还是信任问题——你信不信这个团队的人品和能力。可人品这东西,怎么评?
更魔幻的是,有些评估模型复杂得要命,又是层次分析又是模糊综合,最后得出一个精确到小数点后两位的分数。看起来科学极了,但底层的输入数据还是主观打分。这不就是传说中的‘垃圾进、垃圾出’吗?我有时候觉得,我们花了太多精力折腾评估方法,却忘了最根本的东西:这个技术,到底能不能解决问题?