大数据技术研发:踩坑三年,我终于敢说点真话了
一、搞大数据研发,先从“数仓崩了”说起
做这行快十年,最怕半夜电话。系统报警、数据延迟、老板微信轰炸...说多了都是泪。上周四凌晨两点,跑了两年的ETL任务突然抽风,数据倾斜得要死。原因?用户行为表里多了几个“刷子”账号,当天日志量暴增百倍。 join key 分布不均,导致reduce阶段一个节点卡了四十分钟,其他节点干瞪眼。嘿,这不就是教科书级别的数据倾斜嘛——可遇上了还是手忙脚乱。说实话,当时真想拍桌子:大数据技术研发不能光搞些高大上的算法,这些工程化的破事谁来解决?
后来我们加了预聚合,预先过滤异常数据——把脏活累活前置,而不是在核心链路死扛。其实很多团队都在重蹈覆辙:追着新概念跑,结果基础不牢。我见过用Spark 3.x跑得欢,却连RDD的依赖关系都说不清的小孩,也见过非要把几百兆的数据怼成DataFrame的“大佬”...别笑,真的有。
 大数据技术研发中数据倾斜问题示意图
不过话说回来,这两年研发方向确实变了。以前大家闷头搞性能:CBO优化、列式存储、向量化执行,比谁跑得快。现在呢?数据湖、数据编织、Active Metadata...搞得跟时尚圈似的。但有用吗?有用。只是门槛又被拉高了。
二、Iceberg 这玩意儿,我用完沉默了
 二、Iceberg 这玩意儿,我用完沉默了
去年我们开始上Apache Iceberg。起初是冲着它的ACID事务去的——Hive表加列?加分区?改个字段类型?别闹了,一不留神就是事故。Iceberg的schema演化算是救了我,时间旅行功能更是一绝:有一次业务方误删了某天数据,我淡定地回滚到之前快照,稳如老狗。不过,它也不是万能药。小文件问题仍然存在,compaction策略得自己琢磨,搞不好就性能退化。而且,跟Flink集成时,那个流式写入的一致性保证,我调了一周参数才稳定。痛苦并快乐着——这大概就是研发狗的真实状态。
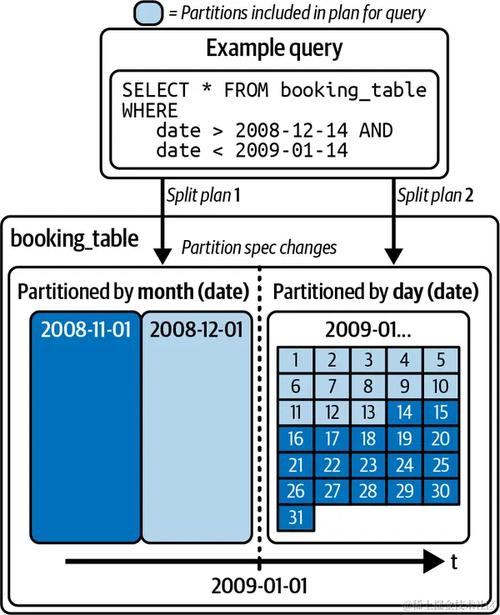 Apache Iceberg表格式文件布局示意图
有人问我为啥不用Delta Lake?各有各的好吧。但Iceberg的抽象更对我的胃口,跟计算引擎解耦得干脆。哦,还有隐藏分区,真的优雅。过去写个SQL要小心翼翼带分区过滤,不然全表扫描直接GG。现在不用显式声明分区字段了,查询引擎自己推导。这种体验,像是从手动挡换到自动挡...但开惯手动的人,偶尔也会觉得自动挡傻快没操控感,对吧?
不过最近社区开始爆炒Apache Paimon(原名Flink Table Store),主打流更新和实时湖仓。看着心痒痒,但我忍住了——技术选型最忌追新,得让子弹再飞一会儿。2019年你追WPF,现在呢?我们这种做基础架构的,稳定性大于一切。
三、流批一体,不是说说而已
 三、流批一体,不是说说而已
三年前老板就画饼:实时数仓要搞起来,流批一体,一套代码两边跑。我当时就觉得不靠谱——Kappa架构听着美,实际呢?存储层不统一,计算层复用难,状态管理就是噩梦。直到最近Flink CDC和Paimon这类技术的成熟,才看到些曙光。上个月我们真的把实时用户宽表和离线宽表用同一套Flink SQL搞定了。T+1变成秒级,业务那边直接沸腾了...但你知道什么最尴尬吗?他们提的需求还是报表,换个姿势看数据而已。唉,用户永远不关心你技术有多牛,他们只关心能不能快点看到结果。所以研发的目的不是炫技,是解决问题——这句话我最近才悟透。
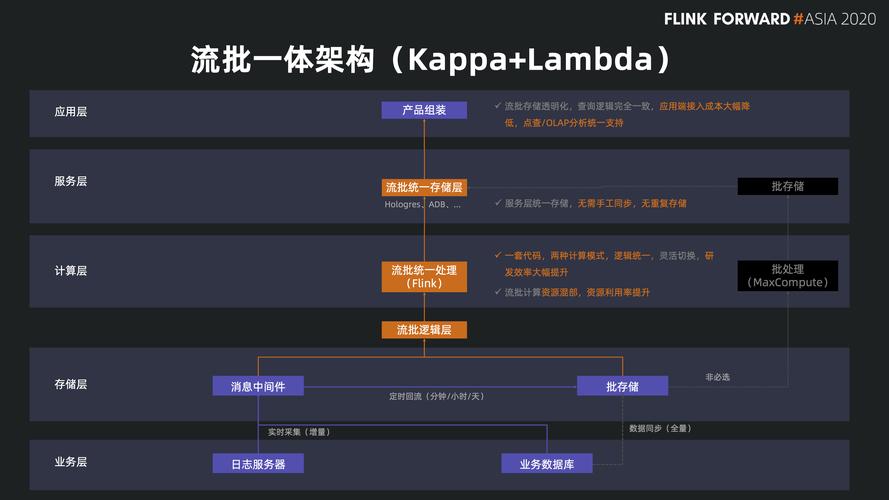 大数据流批一体架构演进示意图
说到实时计算,不得不提数据一致性。Exactly-once? At-least-once? 这些概念翻来覆去讲,但真到生产环境,需要结合具体场景。比如我们有个实时风控模型,微小延迟可能就漏掉欺诈交易,这时候宁可重复计算,也要保证数据完整。所以,别迷信端到端精确一次,那是有代价的。做大数据技术研发最怕变成“PPT架构师”,纸上谈兵。
对了,最近团队引入了一个叫DataFusion的东西,用Rust写的查询引擎,小巧精悍。我们用它在边缘节点做轻量聚合,再传到中心数仓,效果不错。这又让我感慨:十年前谁敢用Rust搞大数据?世界变化快,不学习真跟不上。不过...算了,都是些碎碎念。研发路上坑无数,但每次填坑后的成就感,也是真真切切。或许这就是为什么我还没转行吧。