那个让AI疯狂进化的秘密:反馈循环机制
你知道为什么ChatGPT会那么聪明吗?就是那种好像真的懂你在说什么的聪明。不是那种笨笨的关键词匹配——不,它有时候甚至能猜到你没说出口的下半句。说实话,我第一次用的时候后背发凉。真的。
这种“聪明”的背后,其实藏着一个极其古老,又极其暴力的机制:反馈循环。说白了就是个纠错和迭代的死循环,但正是这个循环,让机器从人工智障进化到了AI。
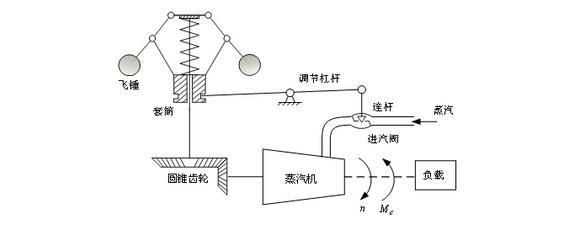 瓦特蒸汽机离心调速器负反馈原理图
然后,计算机来了。然后,AI来了。然后,反馈循环就像被注入氮气的肌肉车,开始狂飙。
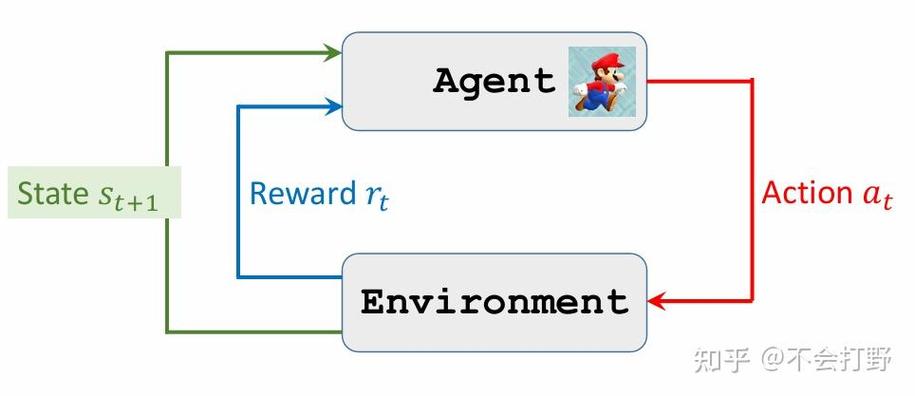 AlphaGo自我对弈强化学习训练循环示意图
这个过程中,奖励信号就是那个“反馈”。赢棋是正反馈,输棋是负反馈。强化学习的本质,就是把智能体扔进一个环境里,让它瞎碰,碰对了给糖,碰错了挨打,久而久之,它就学乖了。
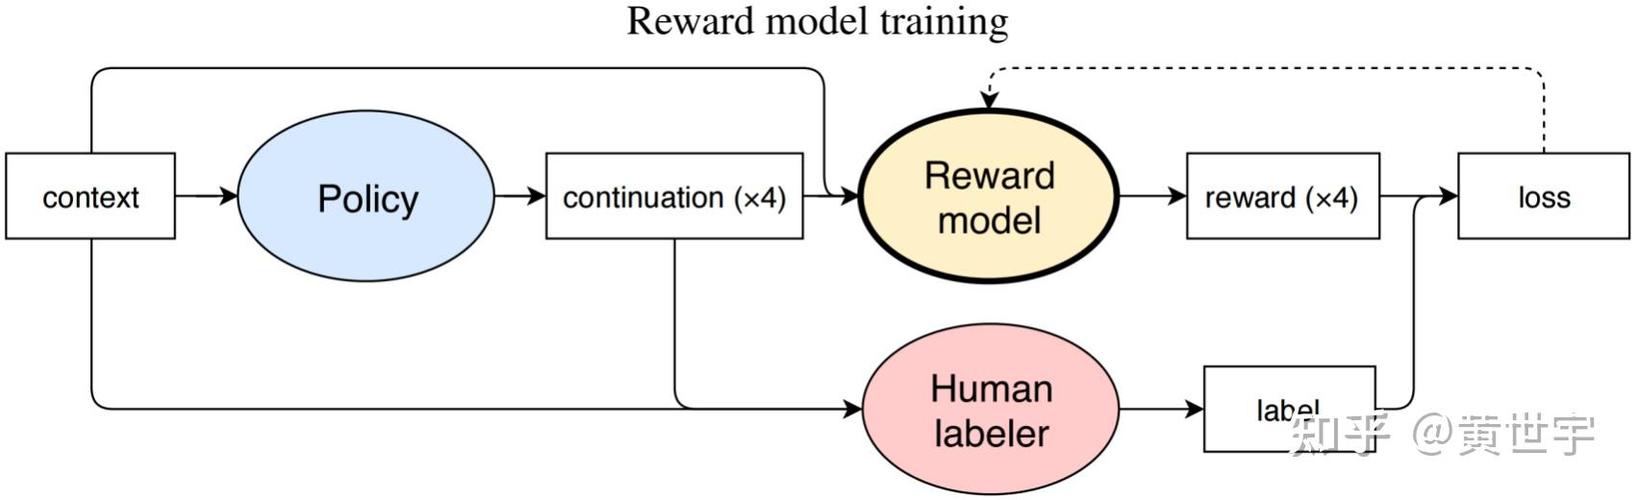 基于人类反馈的强化学习RLHF训练流程
这种机制还带来了意外的副作用:模型退化。你注意到了吗?ChatGPT刚出来时灵气逼人,现在用着用着,感觉变笨了,回答越来越“安全”、越来越啰嗦。有人怀疑,恰恰是RLHF中为了对齐人类价值观,把它的棱角磨平了。这是一个反馈循环的扭曲案例:我们试图用反馈让它变好,但“好”的定义本身就有问题。结果,负反馈抑制了创造性。这很讽刺,不是吗?
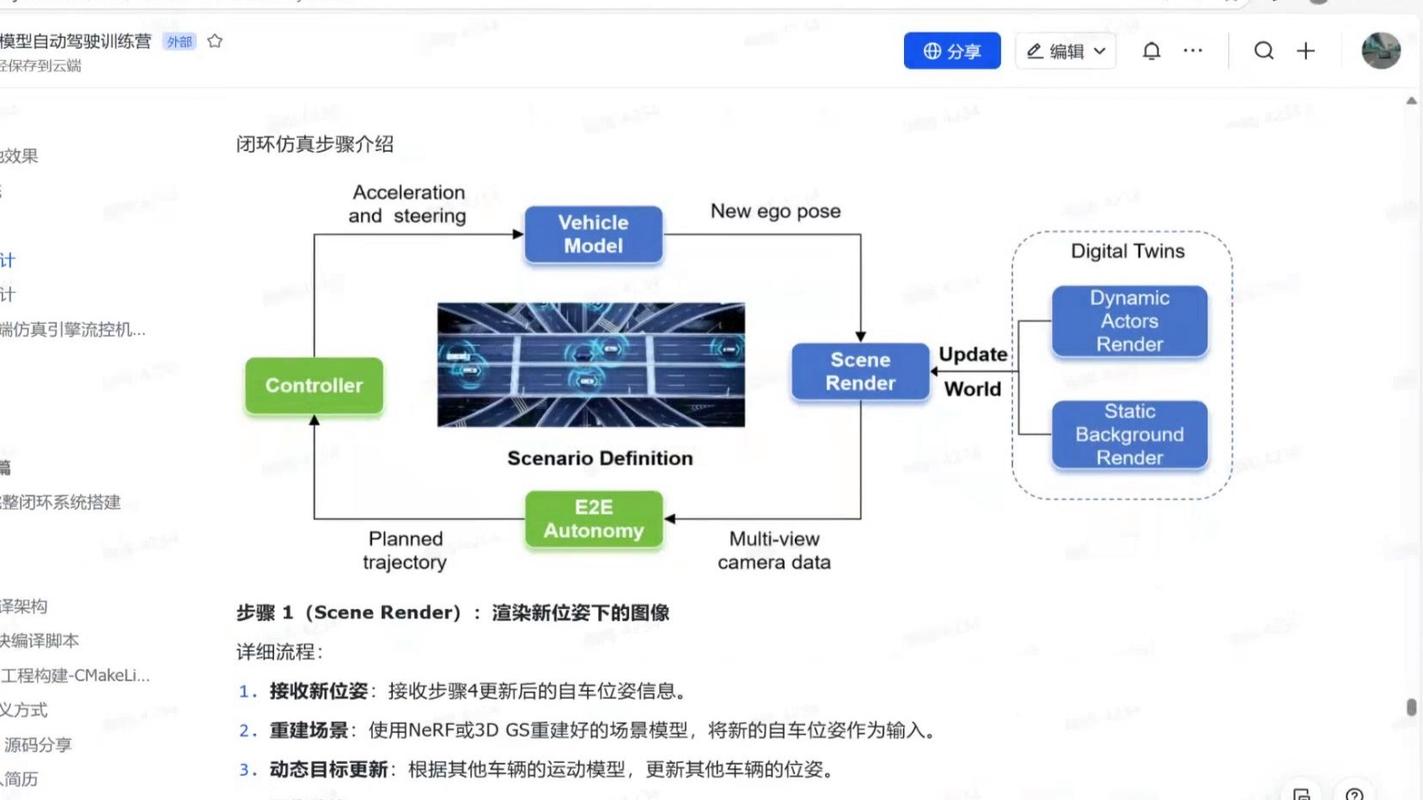 自动驾驶数据闭环训练与部署循环图示
马斯克把这叫做“用影子模式训练AI”。我每次想到这个,就觉得既兴奋又后背发凉。它的进化速度是指数级的,某天你坐上一辆RoboTaxi,可能它的驾驶技术就是从几百万次人类司机的失误中学来的——踩过坑,才知道怎么避坑。反馈循环在这里,是真正人命关天的事情。一丝一毫的奖励函数设计错误,都可能导致灾难。比如,如果惩罚“急刹车”太重,AI可能为了平顺性而选择撞上去?细思极恐。
除了自动驾驶,机器人领域也在狂卷反馈循环。以前工业机器人都是固定程序,现在搞“具身智能”,机器人要自己学会抓取、开门、叠衣服。它每做一次动作,视觉系统就判断结果:东西抓稳了吗?门开了没?衣服叠得怎么样?然后立刻调整下一步发力。这就像婴儿学步,笨拙、反复、但有效。看着波士顿动力的机器人后空翻——那背后是无数次摔倒又爬起的反馈循环。
最后,我想起一个挺哲学的事。有科学家认为,生命本身就是反馈循环的产物:分子自我复制,环境选择,复制出错产生变异,变异被选择……这就是进化。而我们现在造的AI,是不是在另一个维度上,重演了这套几十亿年的老把戏?只不过这次,循环速度快了无数倍,而且——我们人类,似乎既是造物主,又是反馈信号的提供者。我们拼命给AI纠错,AI在飞快地吸收,然后……也许某一天,它反馈给我们一个我们无法理解的世界。
哦对了,结尾没有总结。因为我讨厌总结。
蒸汽机到神经网络:反馈循环的古老血脉
反馈循环不是什么新鲜玩意儿。瓦特发明蒸汽机的时候,就遇到了一个头疼的难题:怎么让引擎稳定运转,别一会儿疯转一会儿停摆?他的解决办法是个天才的机械设计——离心调速器。转速一高,小球甩开,阀门关小;转速低了,小球回落,阀门开大。这就是一个经典的负反馈循环:输出反过来抑制输入,让系统在目标值附近晃悠。 后来,这个思想被维纳发扬光大,搞出了控制论。二战时高射炮打飞机,雷达盯着目标,炮弹打偏了,系统自动修正,开下一炮。这叫闭环控制。你仔细品——这其实就是在说:结果会影响下一步动作。这几乎是所有智能的底层逻辑。瓦特蒸汽机离心调速器负反馈原理图
然后,计算机来了。然后,AI来了。然后,反馈循环就像被注入氮气的肌肉车,开始狂飙。
AI的自我博弈:像疯子一样左右互搏
2016年,AlphaGo赢了李世石。围棋界地震。很多人说这是算法碾压人类,但我看到的是反馈循环的极致暴力美学。 AlphaGo有两个核心网络:策略网络和价值网络。策略网络出招,价值网络判断局面好坏。但真正的秘密武器是自我对弈——它每天自己和自己下几千盘棋,每盘结束后,根据输赢给每一步打分。赢了?那几步的权重就被强化;输了?权重就被惩罚。然后,新的网络再以更强的姿态去和数据生成下一个版本的自己。这就是个循环:数据→训练→更强的对手→生成更高水平的数据→再训练。 你想想,这多可怕。它不需要人类的棋谱,不需要休息,不需要心理疏导——它只是在黑夜中不断地左手打右手,打着打着就成神了。周伯通的左右互搏术被AI实现了,而且疯劲大了一万倍。AlphaGo自我对弈强化学习训练循环示意图
这个过程中,奖励信号就是那个“反馈”。赢棋是正反馈,输棋是负反馈。强化学习的本质,就是把智能体扔进一个环境里,让它瞎碰,碰对了给糖,碰错了挨打,久而久之,它就学乖了。
人类的毒舌成了AI的养料:RLHF的魔力
AlphaGo再强,也只是在围棋这个封闭世界。而我们要的AI,是能陪你聊天、写诗、写代码的那种。这玩意儿开放得无边无界,光靠规则打分根本不现实。怎么办?2022年开始爆发的ChatGPT给出了答案:让人类当裁判。 这就是RLHF(Reinforcement Learning from Human Feedback)。简单说,先训练一个语言模型,然后让它针对同一个问题生成好几个不同的回答。接下来,人类标注员对这些回答进行排序:这个最好,那个还行,那个是垃圾。这些排序数据被用来训练一个“奖励模型”——奖励模型学会了模拟人类的偏好。最后,用这个奖励模型作为反馈信号,再去强化学习调优原始的语言模型。又是一个循环,只不过这次,反馈来自人类的审美和价值观。 说实话,这招既聪明又残酷。聪明的是,它解决了复杂任务无法形式化奖励的问题。残酷的是,人类标注员成了AI的血汗工厂——又有人开玩笑说,我们每个人免费给ChatGPT做反馈,是不是也成了这家公司的“数字奴隶”?不过话又说回来,没有这个反馈循环,ChatGPT可能还分不清什么是“幽默”什么是“冒犯”。基于人类反馈的强化学习RLHF训练流程
这种机制还带来了意外的副作用:模型退化。你注意到了吗?ChatGPT刚出来时灵气逼人,现在用着用着,感觉变笨了,回答越来越“安全”、越来越啰嗦。有人怀疑,恰恰是RLHF中为了对齐人类价值观,把它的棱角磨平了。这是一个反馈循环的扭曲案例:我们试图用反馈让它变好,但“好”的定义本身就有问题。结果,负反馈抑制了创造性。这很讽刺,不是吗?
当下滚烫的闭环:自动驾驶与具身智能
视线从聊天框移开,看看马路。现在最烧钱的赛道——自动驾驶,其实是反馈循环的终极试验场。 特斯拉的FSD(全自动驾驶)正在推v12版本,号称端到端AI,从摄像头输入直接到控制方向盘和刹车的信号。这意味着什么?意味着整个系统成了一个巨大的黑箱神经网络。训练它的方式,也是依托于一个巨大的数据闭环。车在路上跑,驾驶员干预一次(比如踩刹车、掰方向盘),这个干预片段就被标记为“错误”。数据回传到云端,与正常行驶的数据混合,重新训练模型,然后OTA推送给百万辆车。车再继续跑,收集更多干预数据……又一个循环。自动驾驶数据闭环训练与部署循环图示
马斯克把这叫做“用影子模式训练AI”。我每次想到这个,就觉得既兴奋又后背发凉。它的进化速度是指数级的,某天你坐上一辆RoboTaxi,可能它的驾驶技术就是从几百万次人类司机的失误中学来的——踩过坑,才知道怎么避坑。反馈循环在这里,是真正人命关天的事情。一丝一毫的奖励函数设计错误,都可能导致灾难。比如,如果惩罚“急刹车”太重,AI可能为了平顺性而选择撞上去?细思极恐。
除了自动驾驶,机器人领域也在狂卷反馈循环。以前工业机器人都是固定程序,现在搞“具身智能”,机器人要自己学会抓取、开门、叠衣服。它每做一次动作,视觉系统就判断结果:东西抓稳了吗?门开了没?衣服叠得怎么样?然后立刻调整下一步发力。这就像婴儿学步,笨拙、反复、但有效。看着波士顿动力的机器人后空翻——那背后是无数次摔倒又爬起的反馈循环。
最后,我想起一个挺哲学的事。有科学家认为,生命本身就是反馈循环的产物:分子自我复制,环境选择,复制出错产生变异,变异被选择……这就是进化。而我们现在造的AI,是不是在另一个维度上,重演了这套几十亿年的老把戏?只不过这次,循环速度快了无数倍,而且——我们人类,似乎既是造物主,又是反馈信号的提供者。我们拼命给AI纠错,AI在飞快地吸收,然后……也许某一天,它反馈给我们一个我们无法理解的世界。
哦对了,结尾没有总结。因为我讨厌总结。