智能运维管理:为什么你的监控系统总在关键时刻掉链子?
刚帮一个创业团队救火回来,他们用的还是那套开源的监控组合——Prometheus加Grafana,配上ELK。说实话,一开始跑得挺好,直到某天夜里流量峰值把某个微服务的连接池打满,告警风暴直接糊脸,手机震得像要爆炸。我在想,智能运维管理这四个字,到底意味着什么?是自动化?是预测?还是仅仅把人工做的事换成了脚本?
我们总爱说“上了AIOps就万事大吉”,不过话说回来,真正落地的人才知道有多坑。算法模型漂移、数据噪声、上下文缺失……这些词儿听着挺学术,落到现实就是:你花了三个月训练出来的异常检测模型,在双十一当天把正常的促销流量误判为DDoS攻击,自动触发封IP策略——那画面太美我不敢看。
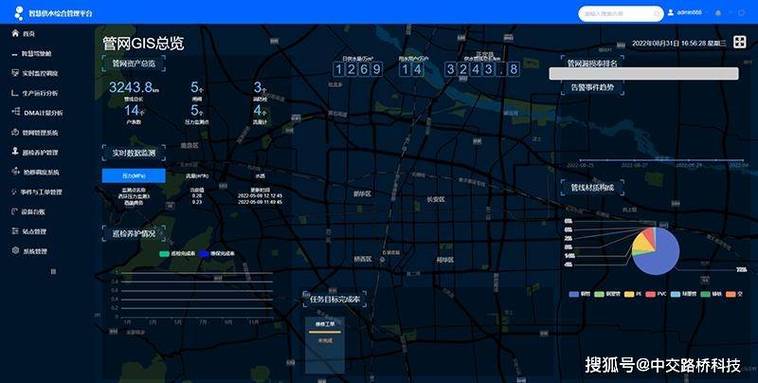 双十一期间智能运维监控大屏误报洪水警报
告警疲劳不是你的错,是架构设计在偷懒
还记得2019年谷歌那篇关于“告警管理”的SRE论文吗?里面提到一个扎心的数据:超过70%的告警从未被真正处理过。它们要么是误报,要么是重复信息,要么优先级错乱。我亲眼见过一个团队,运维群里每天弹出上千条告警,最后干脆全员静音——这叫什么?告警疲劳,比996还消磨意志。
后来有人想出“告警降噪”的方案。不是简单的聚合或抑制,而是基于拓扑因果推断。举个例子:一个数据库主库故障,可能导致依赖它的几十个服务全红。传统监控会给你下暴雨,智能系统应该能识别出“根因就是那个DB实例”,然后只推送一条关键告警。北京某大厂就这么干过,他们把告警压缩了90%,但前提是CMDB和调用链数据必须精准得像手术刀。可我转念一想——有多少公司的CMDB是千年难改的静态表?更新靠人工,错误率堪比天气预报。
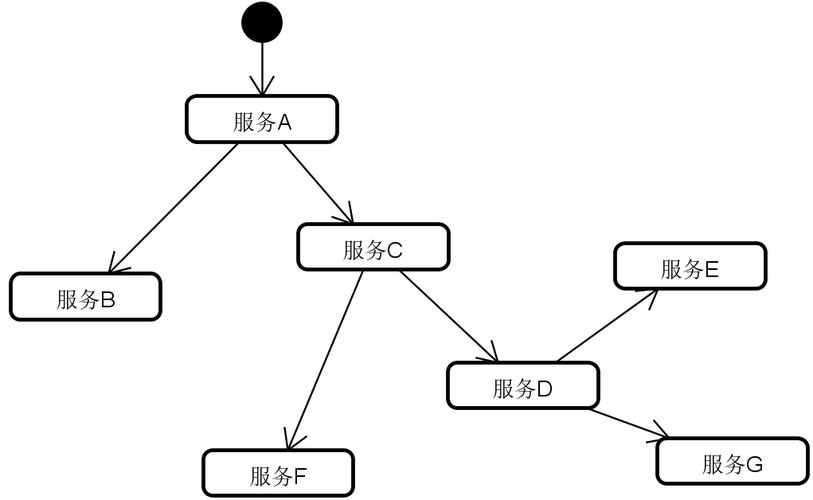 基于调用链拓扑的告警收敛示意图
模型不是魔法,它需要喂“人话”
 模型不是魔法,它需要喂“人话”
上周和一个AI研究员喝酒,他吐槽说现在很多人把智能运维当万能灵药,以为丢一堆日志给算法就能吐出预测。太天真了!运维数据是出了名的脏、乱、非结构化。就拿日志来说,不同开发者写的格式千奇百怪:“ERROR: connection timeout”和“妈呀连不上DB了!!!”——后者真出现在某初创公司的代码里。你不做文本解析和语义标准化,直接扔进模型,结果就是灾难。
学术界这几年搞了不少预训练模型,像LogBERT、LogGPT,试图从日志序列里学习模式。但工程落地远比发论文复杂。我见过一个案例,团队用B型模型预测硬盘故障,准确率高达95%,结果上线后发现,模型把“人工定期重启服务器前的日志模式”当成了即将挂盘的信号——因为历史数据里,每次重启前后都有人为操作标记。这叫什么?数据偏见。不把运维人员的操作上下文纳入特征,模型就是个瞎子。
不过话说回来,最近倒是有个让我眼前一亮的方向:多模态融合。把指标、日志、调用链、甚至工单系统里的文本描述揉在一起做联合学习。比如某电商平台,他们发现单纯看CPU飙高无法区分是代码死循环还是促销抢购,但如果同时分析日志里的“OutOfMemoryError”和工单中出现的“下单失败”关键词,判断就准多了。这需要构建一个统一的特征向量空间,技术细节暂且不表,但本质就是让模型更“懂业务”。
人机协同?不,是“人教机器做人”
不要被全自动运维的幻想忽悠了。至少在关键业务上,让AI直接执行变更,你敢吗?反正我不敢。我比较认同的是“人在回路”(Human-in-the-Loop)的实践。机器负责筛选可疑事件、推荐修复方案,最后由运维老司机拍板。这里有个反直觉的发现:信任度不是靠准确率堆上去的,而是靠可解释性。
曾在一个研讨会上看到,某银行运维团队试用AIOps平台,算法推荐了调整JVM参数的建议,但没给出理由。结果没人敢动,因为上次有人调了堆大小导致Full GC频繁,差点造成交易超时。后来平台加了一个功能:弹出一个解释面板,说“基于过去48小时的平均GC暂停时间为0.8秒,超过阈值0.5秒,建议调大新生代至2GB,预计将暂停时间降低40%”——附带类似历史案例的三个成功链接。你猜怎么着?接受率从10%飙升到70%。所以,解释比预测更重要。
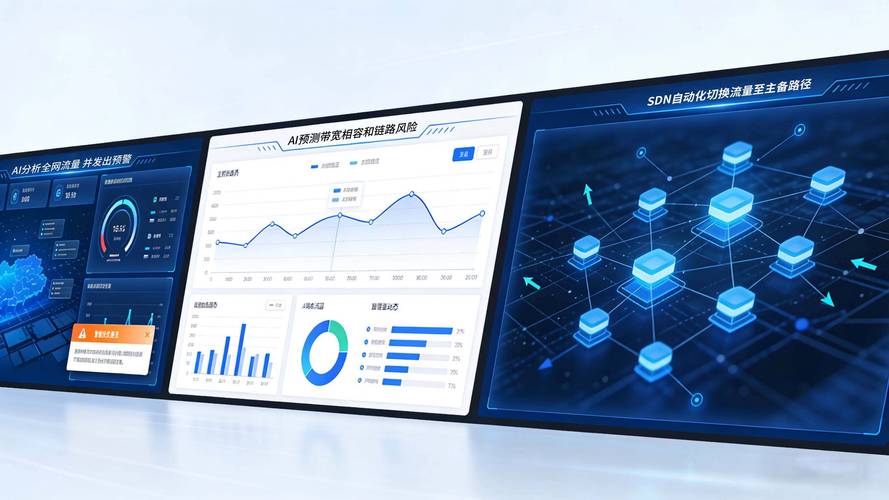 AI运维建议的可解释性面板展示
还有成本问题。很多人忽略了一点:智能运维系统本身的运维成本。模型需要持续训练,特征管道要维护,推理延迟要控制。某视频网站上了实时异常检测,结果每天光处理千万级指标的开销就比云服务器还贵。最后他们搞了个轻量化模型+边缘推理的方案,把模型压到几十MB,丢在K8s的DaemonSet里跑,效果折中但成本省了八成。
写到这儿,我看了看手边的运动手环——它默默震了一下,提醒我久坐。突然觉得,智能运维本质上不就是给系统戴上健康监测设备吗?只是人懂疲劳,机器只懂信号。而我们要做的,是把这些冰冷的信号,翻译成有温度、有上下文、值得信任的决策依据。这条路还很长,坑还很多。但至少,别再用“智能”两个字来掩盖架构的懒惰了,对吧?